Rust
基本使用
这里仅提一嘴容易忽略的细节
具体看rust语言圣经
基本类型
字符char占用4个字节,表示一个Unicode
单元类型(),占位符,不占用任何内存
打印变量所占字节
函数
- 函数名和变量名使用蛇形命名法(snake case),例如
fn add_two() -> {} - 函数的位置可以随便放,Rust 不关心我们在哪里定义了函数,只要有定义即可
- 每个函数参数都需要标注类型
发散函数
当用 ! 作函数返回类型的时候,表示该函数永不返回( diverge function ),特别的,这种语法往往用做会导致程序崩溃的函数:
下面的函数创建了一个无限循环,该循环永不跳出,因此函数也永不返回:
为什么需要发散函数?
例如一个服务器的守护进程可能是无限循环的,因此是发散函数。
函数里部分代码因为各种原因暂时留空不写时,程序会因为缺少对应类型返回值无法通过编译;如果暂时给返回值类型记作
(),那么到时这些函数需要全部都批量修改函数签名会很麻烦;更不用说如果有已实现分支返回预期的类型,那么未实现的分支就必须捏造一个符合返回类型的值返回,这非常恼人;而todo!()unimplement!()这些宏配合!类型使用,便于后面搜索关键词进行代码补充。
unimplemented!()告诉编译器该函数尚未实现,unimplemented!()标记通常意味着我们期望快速完成主要代码,回头再通过搜索这些标记来完成次要代码,类似的标记还有todo!(),当代码执行到这种未实现的地方时,程序会直接报错。
例如:
fn main() {
    example1();
    // example函数不返回,不会到达这一步
    println!("hello");
}

fn example() -> !{
    unimplemented!();
}
复合类型
切片
引用集合部分连续的元素序列
创建切片的语法,使用方括号包括的一个序列:[开始索引..终止索引],其中开始索引是切片中第一个元素的索引位置,而终止索引是最后一个元素后面的索引位置
字符串
Rust 中的字符是 Unicode 类型,因此每个字符占据 4 个字节内存空间,但是在字符串中不一样,字符串是 UTF-8 编码,也就是字符串中的字符所占的字节数是变化的(1 - 4),这样有助于大幅降低字符串所占用的内存空间。
str 类型是硬编码进可执行文件,也无法被修改(正常情况下我们无法使用 str 类型)
但是 String 则是一个可增长、可改变且具有所有权的 UTF-8 编码字符串,当 Rust 用户提到字符串时,往往指的就是 String 类型和 &str 字符串切片类型,这两个类型都是 UTF-8 编码。
除了 String 类型的字符串,Rust 的标准库还提供了其他类型的字符串,例如 OsString, OsStr, CsString 和 CsStr 等,注意到这些名字都以 String 或者 Str 结尾了吗?它们分别对应的是具有所有权和被借用的变量。
UTF8 和Unicode区别
https://www.ruanyifeng.com/blog/2007/10/ascii_unicode_and_utf-8.html
字符串切片
字符串不允许索引,只允许字符串切片索引
在对字符串使用切片语法时需要格外小心,切片的索引必须落在字符之间的边界位置,也就是 UTF-8 字符的边界,例如中文在 UTF-8 中占用三个字节,下面的代码就会崩溃:
因为我们只取
s字符串的前两个字节,但是本例中每个汉字占用三个字节,因此没有落在边界处,也就是连中字都取不完整,此时程序会直接崩溃退出,如果改成&s[0..3],则可以正常通过编译。
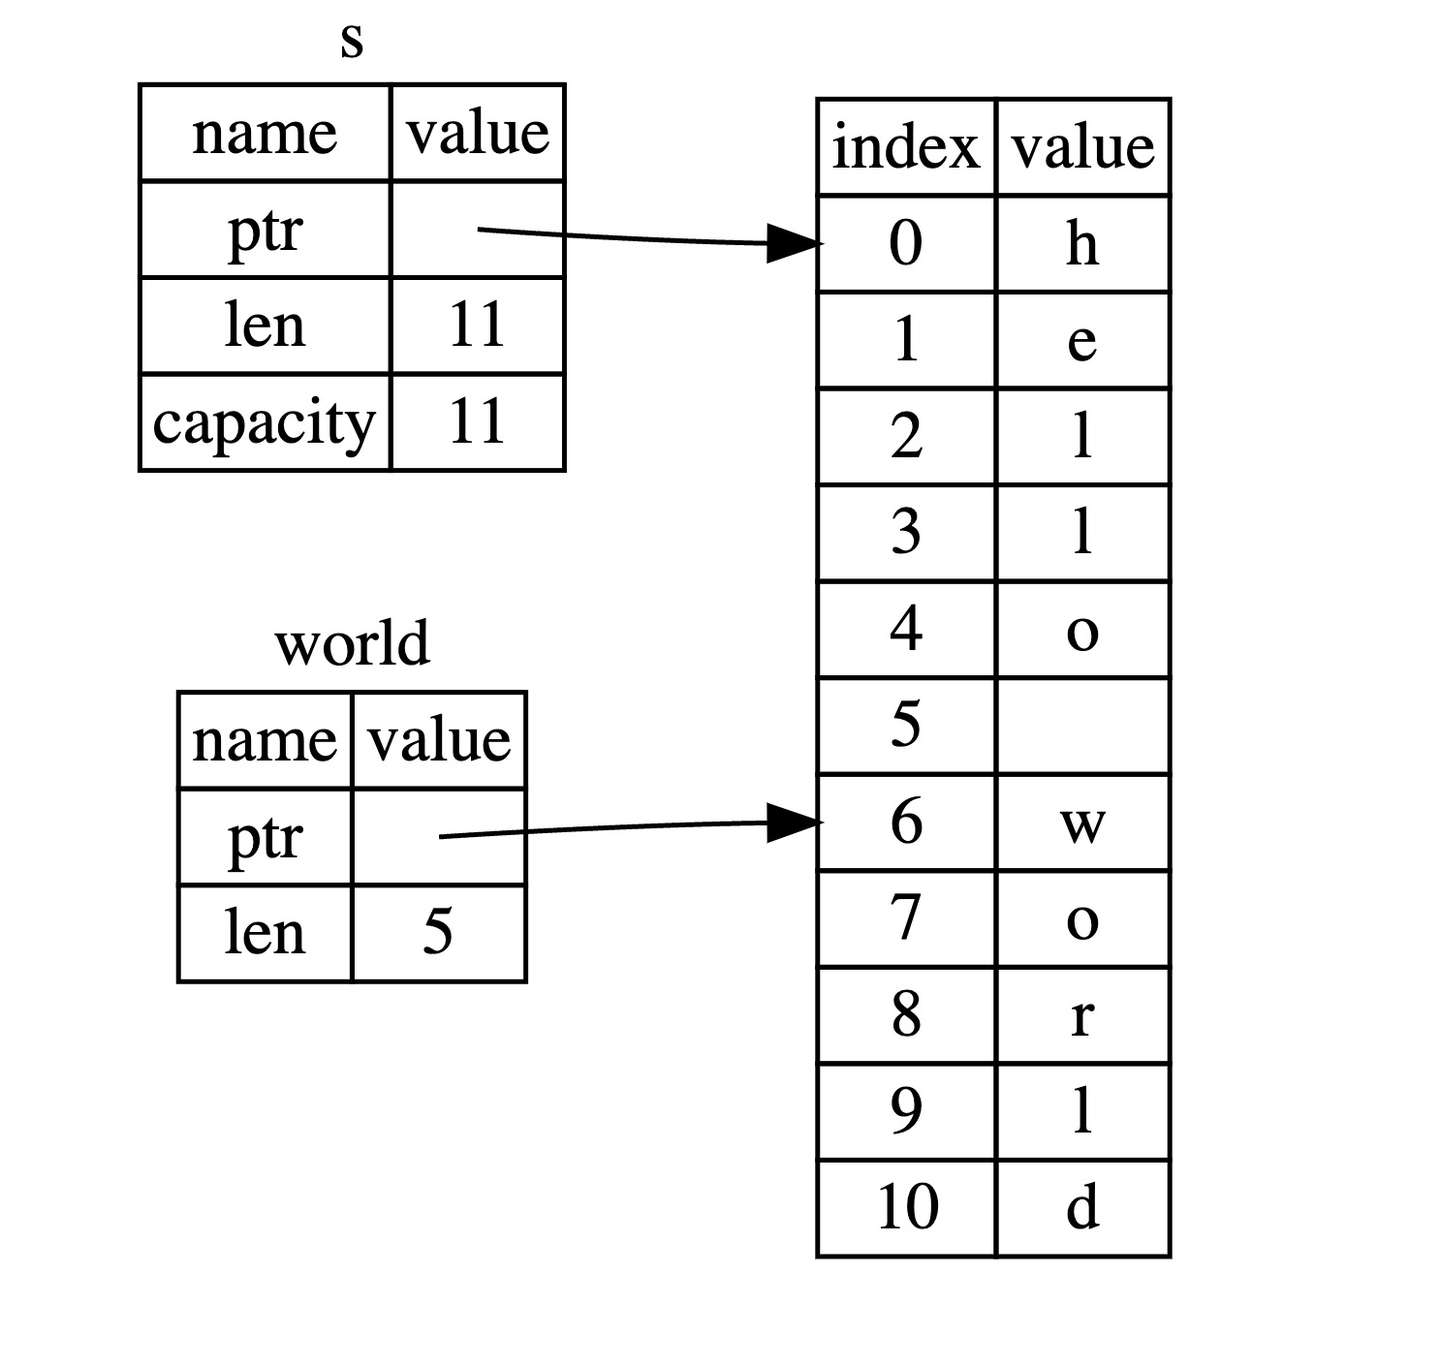
字符串字面值:
- 类型为&str
- 本质上字面值的值存储在二进制可执行文件中,字符串字面值为该值的引用,因此返回&str
字符串与字符串切片相互转换
let s1 = String::from("hello"); //&str -> String
let s2 = &s1; //&String -> &str
let s3 = &s1[1..3]; //&String -> &str
let s4 = s1.as_str(); //&String -> &str
let s5 = "hello".to_string(); //&str -> String
前文提到了几种使用 UTF-8 字符串的方式,下面来一一说明。
遍历字符串
字符
如果你想要以 Unicode 字符的方式遍历字符串,最好的办法是使用 chars 方法,例如:
输出如下
字节
这种方式是返回字符串的底层字节数组表现形式:
输出如下:
获取子串
想要准确的从 UTF-8 字符串中获取子串是较为复杂的事情,例如想要从 holla中国人नमस्ते 这种变长的字符串中取出某一个子串,使用标准库你是做不到的。 你需要在 crates.io 上搜索 utf8 来寻找想要的功能。
可以考虑尝试下这个库:utf8_slice。
字符串基本使用
https://course.rs/basic/compound-type/string-slice.html#%E6%93%8D%E4%BD%9C%E5%AD%97%E7%AC%A6%E4%B8%B2
拼接字符串
fn main() {
    let s1 = String::from("hello,");
    let s2 = String::from("world!");
    //let s3 = s1+ &s2; 会导致s1的所有权转移给s3
    let s3 = s1.clone() + &s2;
    assert_eq!(s3,"hello,world!");
    println!("{}",s1);
}
结构体
先来看以下代码:
#[derive(Debug)]
 struct File {
   name: String,
   data: Vec<u8>,
 }

 fn main() {
   let f1 = File {
     name: String::from("f1.txt"),
     data: Vec::new(),
   };

   let f1_name = &f1.name;
   let f1_length = &f1.data.len();

   println!("{:?}", f1);
   println!("{} is {} bytes long", f1_name, f1_length);
 }
上面定义的 File 结构体在内存中的排列如下图所示: 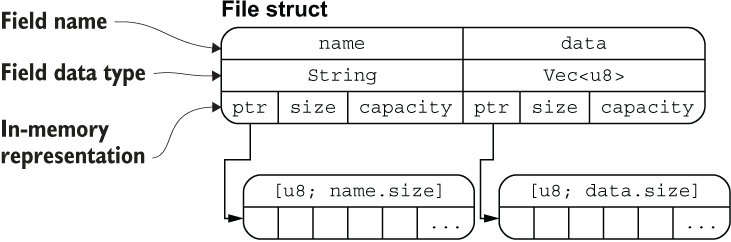
从图中可以清晰地看出 File 结构体两个字段 name 和 data 分别拥有底层两个 [u8] 数组的所有权(String 类型的底层也是 [u8] 数组),通过 ptr 指针指向底层数组的内存地址,这里你可以把 ptr 指针理解为 Rust 中的引用类型。
该图片也侧面印证了:把结构体中具有所有权的字段转移出去后,将无法再访问该字段,但是可以正常访问其它的字段。
数组
数组切片&[T]包含指针和长度,数组切片的通用情况,包含
- 数组局部引用
- 数组全部引用
数组切片&[T:len]特指全部元素数组的引用,len为数组长度
[T;len]为数组的类型
数组的模式匹配
https://course.rs/basic/match-pattern/all-patterns.html#%E8%A7%A3%E6%9E%84%E6%95%B0%E7%BB%84
所有权
谨记一句话,所有权适用于所有变量,但是所有权的转移发生在复杂类型上(没有实现Copy的Trait)
基础三大原则
- Rust 中每一个值都被一个变量所拥有,该变量被称为值的所有者
- 一个值同时只能被一个变量所拥有,或者说一个值只能拥有一个所有者
- 当所有者(变量)离开作用域范围时,这个值将被丢弃(drop)
例子
对于存储在栈上的基础数据类型,直接拷贝即可
以上代码没有发生所有权的转移
对于存储在堆上的复合类型(以String为例)
- 给定堆上的某个地址,在堆上存储数据
- 由于地址大小固定,因此栈存储该地址
//例2
let s1 = String::from("hello");
let s2 = s1;

println!("{}, world!", s1); //会报错value borrowed here after move
以上代码发生了所有权转移,s1变为无效了
特别的,
以上代码也没有发生所有权转移,y复制了x的引用,x和y都引用同一个字符串
【重点】所有权转移的原理
对于复杂类型,栈存储该类型的指针,长度以及内存大小
对于例2的代码,s2拷贝了s1在栈上的数据结构(指针,长度以及内存大小),而没有拷贝数据本身
为了避免二次释放,rust将s1无效,这就是所有权转移
有点像c++里的std::move
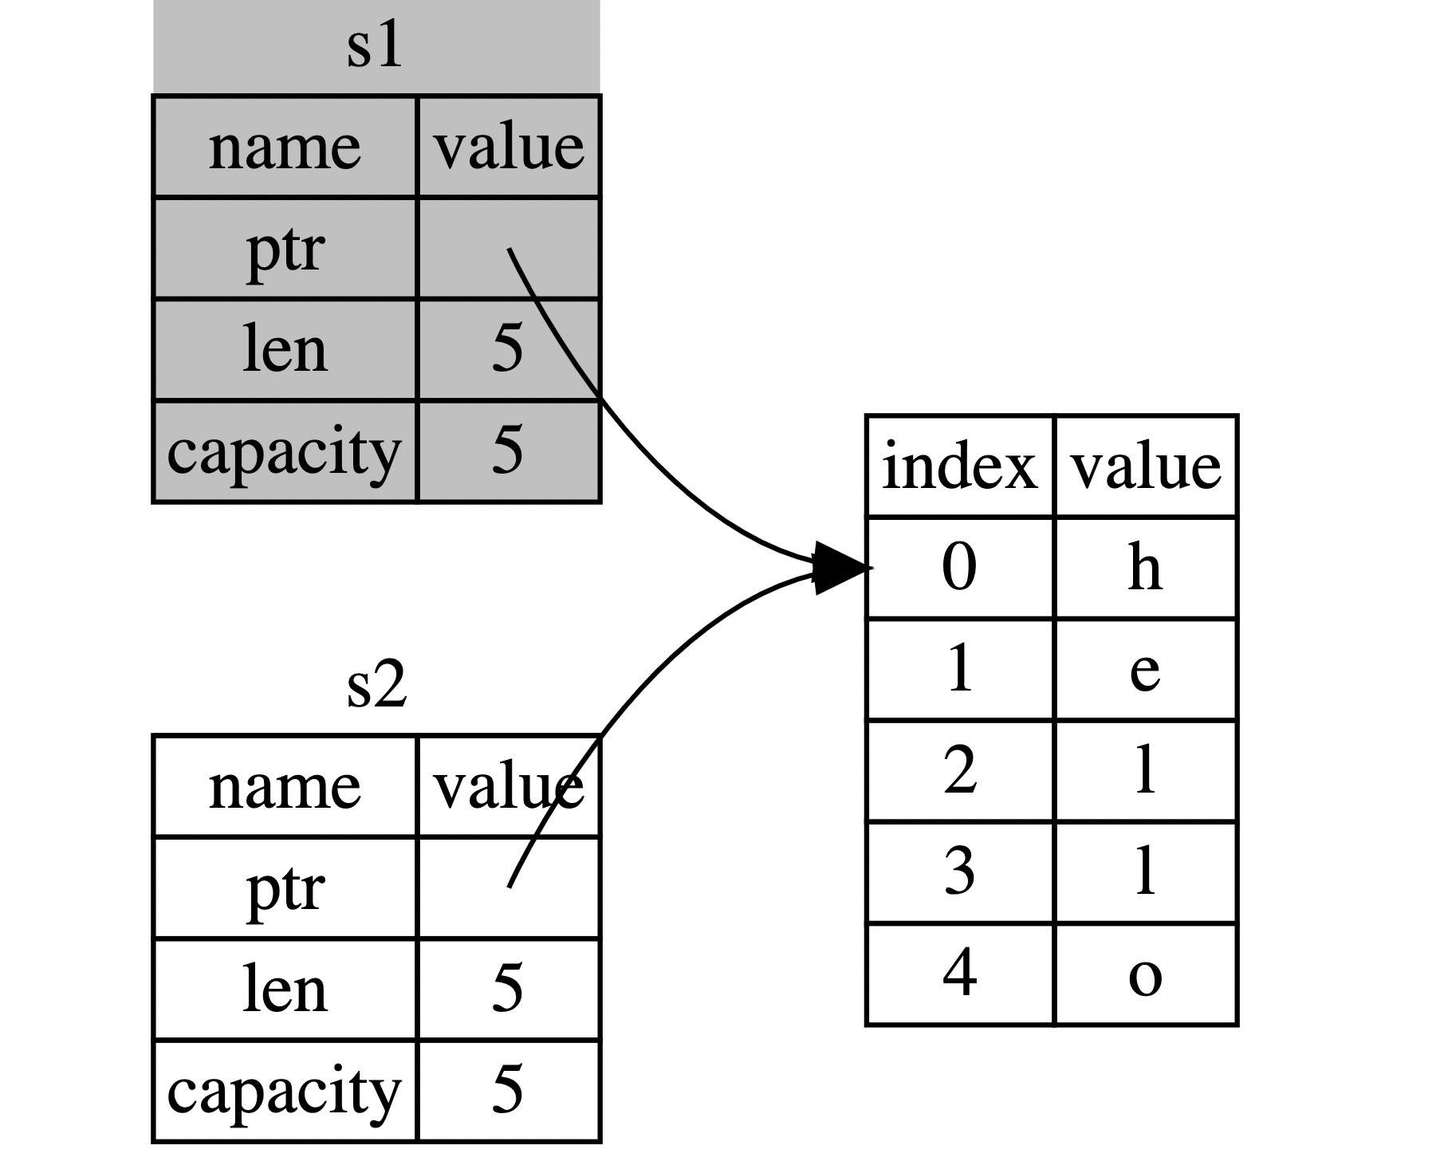
【重点】什么时候会发生所有权转移?
-
如果一个类型实现了Copy的Trait,那么该类型赋值的过程就是拷贝的过程(对应例1和例3)
如下是一些
Copy的类型:- 所有整数类型,比如
u32 - 布尔类型,
bool,它的值是true和false - 所有浮点数类型,比如
f64 - 字符类型,
char - 元组,当且仅当其包含的类型也都是
Copy的时候。比如,(i32, i32)是Copy的,但(i32, String)就不是 - 不可变引用
&T,但是注意:可变引用&mut T是不可以 Copy的
- 所有整数类型,比如
-
否则,则会发生所有权转移
【重点】如果不想发生所有权转移?
则可以使用深拷贝clone,但是性能会下降
函数中的所有权
将值传递给函数,一样会发生 移动 或者 复制,就跟 let 语句一样,下面的代码展示了所有权、作用域的规则:
fn main() {
    let s = String::from("hello");  // s 进入作用域

    takes_ownership(s);             // s 的值移动到函数里 ...
                                    // ... 所以到这里不再有效

    let x = 5;                      // x 进入作用域

    makes_copy(x);                  // x 应该移动函数里,
                                    // 但 i32 是 Copy 的,所以在后面可继续使用 x

} // 这里, x 先移出了作用域,然后是 s。但因为 s 的值已被移走,
  // 所以不会有特殊操作

fn takes_ownership(some_string: String) { // some_string 进入作用域
    println!("{}", some_string);
} // 这里,some_string 移出作用域并调用 `drop` 方法。占用的内存被释放

fn makes_copy(some_integer: i32) { // some_integer 进入作用域
    println!("{}", some_integer);
} // 这里,some_integer 移出作用域。不会有特殊操作
你可以尝试在 takes_ownership 之后,再使用 s,看看如何报错?例如添加一行 println!("在move进函数后继续使用s: {}",s);。
同样的,函数返回值也有所有权,例如:
fn main() {
    let s1 = gives_ownership();         // gives_ownership 将返回值
                                        // 移给 s1

    let s2 = String::from("hello");     // s2 进入作用域

    let s3 = takes_and_gives_back(s2);  // s2 被移动到
                                        // takes_and_gives_back 中,
                                        // 它也将返回值移给 s3
} // 这里, s3 移出作用域并被丢弃。s2 也移出作用域,但已被移走,
  // 所以什么也不会发生。s1 移出作用域并被丢弃

fn gives_ownership() -> String {             // gives_ownership 将返回值移动给
                                             // 调用它的函数

    let some_string = String::from("hello"); // some_string 进入作用域.

    some_string                              // 返回 some_string 并移出给调用的函数
}

// takes_and_gives_back 将传入字符串并返回该值
fn takes_and_gives_back(a_string: String) -> String { // a_string 进入作用域

    a_string  // 返回 a_string 并移出给调用的函数
}
所有权很强大,避免了内存的不安全性,但是也带来了一个新麻烦: 总是把一个值传来传去来使用它。 传入一个函数,很可能还要从该函数传出去,结果就是语言表达变得非常啰嗦,幸运的是,Rust 提供了新功能解决这个问题。
借用
引用:对某个变量取地址
借用:使用某变量的引用,例如let s = &s1
借用两大特性
- 同一时刻,你只能拥有要么一个可变引用,要么任意多个不可变引用
- 引用必须总是有效的
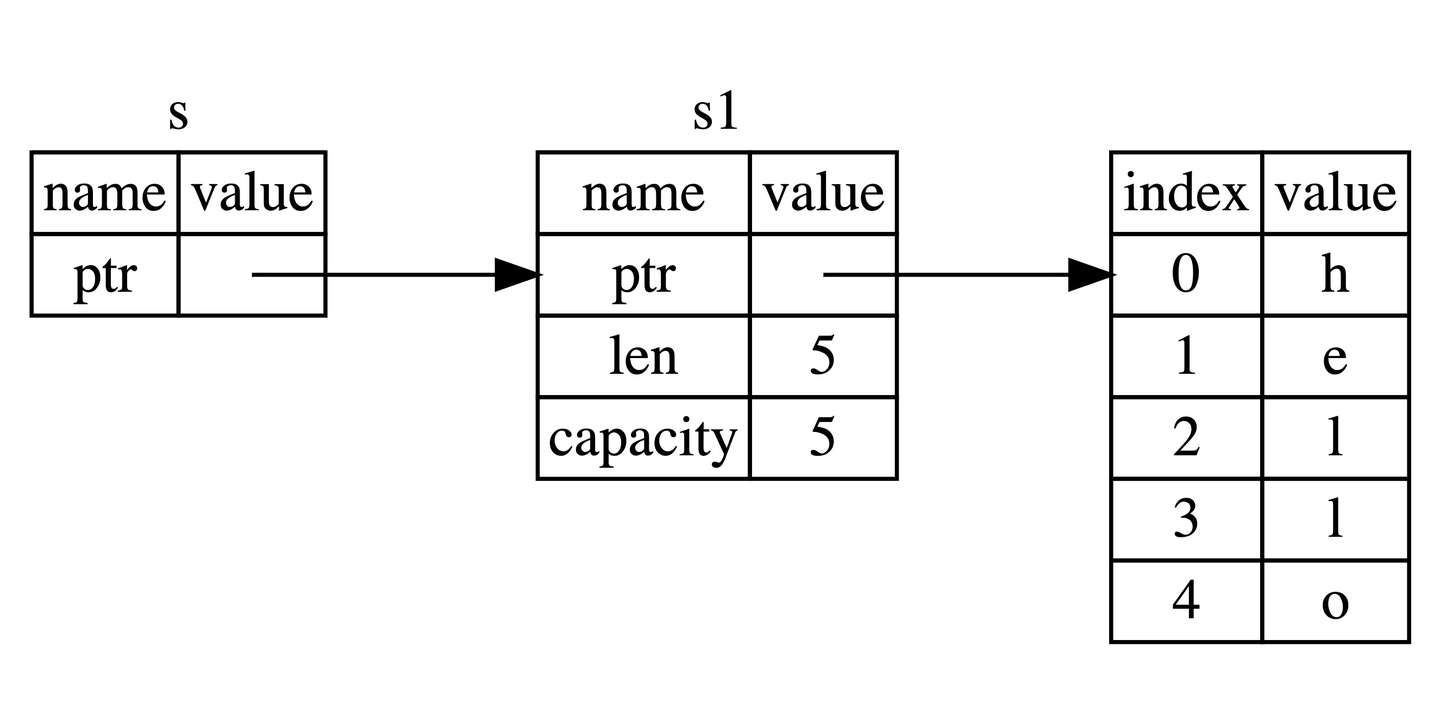
注意,引用的作用域 s 从创建开始,一直持续到它最后一次使用的地方,这个跟变量的作用域有所不同,变量的作用域从创建持续到某一个花括号 }
对于这种编译器优化行为,Rust 专门起了一个名字 —— Non-Lexical Lifetimes(NLL),专门用于找到某个引用在作用域(})结束前就不再被使用的代码位置。
fn main() {
   let mut s = String::from("hello");

    let r1 = &s;
    let r2 = &s;
    println!("{} and {}", r1, r2);
    // 新编译器中,r1,r2作用域在这里结束

    let r3 = &mut s;
    println!("{}", r3);
} // 老编译器中,r1、r2、r3作用域在这里结束
  // 新编译器中,r3作用域在这里结束
返回引用可能会导致悬垂指针(返回指针,但是指针所指向的内存可能不存在任何值或已被其它变量重新使用),Rust编译器会报错,解决这部分需要用到生命周期的知识
模式匹配
无论是 match 还是 if let,这里都是一个新的代码块,而且这里的绑定相当于新变量,如果你使用同名变量,会发生变量遮蔽
https://course.rs/basic/match-pattern/match-if-let.html#%E5%8F%98%E9%87%8F%E9%81%AE%E8%94%BD
while let 条件循环
一个与 if let 类似的结构是 while let 条件循环,它允许只要模式匹配就一直进行 while 循环。下面展示了一个使用 while let 的例子:
// Vec是动态数组
let mut stack = Vec::new();

// 向数组尾部插入元素
stack.push(1);
stack.push(2);
stack.push(3);

// stack.pop从数组尾部弹出元素
while let Some(top) = stack.pop() {
    println!("{}", top);
}
这个例子会打印出 3、2 接着是 1。pop 方法取出动态数组的最后一个元素并返回 Some(value),如果动态数组是空的,将返回 None,对于 while 来说,只要 pop 返回 Some 就会一直不停的循环。一旦其返回 None,while 循环停止。我们可以使用 while let 来弹出栈中的每一个元素。
你也可以用 loop + if let 或者 match 来实现这个功能,但是会更加啰嗦。
If-else
if let 写法里的 x 只能在 if 分支内使用,而 let-else 写法里的 x 则可以在 let 之外使用。
https://course.rs/basic/match-pattern/pattern-match.html#let-elserust-165-%E6%96%B0%E5%A2%9E
数组的模式匹配
https://course.rs/basic/match-pattern/all-patterns.html#%E8%A7%A3%E6%9E%84%E6%95%B0%E7%BB%84
特殊符号
_ 模式忽略一个值,或者使用 .. 忽略多个值。
绑定@
@绑定可能是所有模式匹配中最难记忆的一个。
我现在这样助记: @ 符号右侧的 Point {x: px, y: py } 是一个模式(pattern), 如果这个模式匹配就把匹配值绑定到 @ 符号左侧的 p 变量上。
https://course.rs/basic/match-pattern/all-patterns.html#%E7%BB%91%E5%AE%9A
泛型
泛型适用于枚举、结构体、函数等
https://course.rs/basic/trait/generic.html
不仅可以给泛型定义方法,还可以给特定类型制定方法
https://course.rs/basic/trait/generic.html#%E4%B8%BA%E5%85%B7%E4%BD%93%E7%9A%84%E6%B3%9B%E5%9E%8B%E7%B1%BB%E5%9E%8B%E5%AE%9E%E7%8E%B0%E6%96%B9%E6%B3%95
特征Trait
特征类似于Go语言及其他语言中的“接口”
- 我们可以通过特征定义一系列可以被共享行为的集合
- 特征约束(Trait bound)
- 我们可以通过为参数设定特征约束,从而能够更方便传入所有满足该特征的结构体或其他数据类型;同时也约束了只有实现该特征的参数才能传入
- 特征支持默认实现,能够实现重载
有几点需要注意
-
如果你想要为类型
A实现特征T,那么A或者T至少有一个是在当前作用域中定义的!- 如果当前特征不在/如果当前类型不在,那么需要使用use引入或自行创建
-
能够使用特征约束有条件地实现方法或特征
https://course.rs/basic/trait/trait.html#%E4%BD%BF%E7%94%A8%E7%89%B9%E5%BE%81%E7%BA%A6%E6%9D%9F%E6%9C%89%E6%9D%A1%E4%BB%B6%E5%9C%B0%E5%AE%9E%E7%8E%B0%E6%96%B9%E6%B3%95%E6%88%96%E7%89%B9%E5%BE%81
-
通过derive派生特征:被
derive标记的对象会自动实现对应的默认特征代码,继承相应的功能。 -
如果你要使用一个特征的方法,那么你需要将该特征引入当前的作用域中(暂时没懂?
https://course.rs/basic/trait/trait.html#%E8%B0%83%E7%94%A8%E6%96%B9%E6%B3%95%E9%9C%80%E8%A6%81%E5%BC%95%E5%85%A5%E7%89%B9%E5%BE%81
-
2
格式化输出
https://course.rs/basic/formatted-output.html
{}适用于实现了std::fmt::Display特征的类型,用来以更优雅、更友好的方式格式化文本,例如展示给用户- 需要自己实现Display特征
{:?}适用于实现了std::fmt::Debug特征的类型,用于调试场景- 直接使用或使用派生类#[derive(Debug)]
:#?}与{:?}几乎一样,唯一的区别在于它能更优美地输出内容
其实两者的选择很简单,当你在写代码需要调试时,使用 {:?},剩下的场景,选择 {}。
生命周期
生命周期语法用来将函数的多个引用参数和返回值的作用域关联到一起,一旦关联到一起后,Rust 就拥有充分的信息来确保我们的操作是内存安全的。
生命周期本质两大规则
- 生命周期标注并不会改变任何引用的实际作用域
- 在通过函数签名指定生命周期参数时,我们并没有改变传入引用或者返回引用的真实生命周期,而是告诉编译器当不满足此约束条件时,就拒绝编译通过。
- 生命周期
'a不代表生命周期等于'a,而是大于等于'a
生命周期三大规则
-
每一个引用参数都会获得独自的生命周期
例如一个引用参数的函数就有一个生命周期标注:
fn foo<'a>(x: &'a i32),两个引用参数的有两个生命周期标注:fn foo<'a, 'b>(x: &'a i32, y: &'b i32), 依此类推。 -
若只有一个输入生命周期(函数参数中只有一个引用类型),那么该生命周期会被赋给所有的输出生命周期,也就是所有返回值的生命周期都等于该输入生命周期
例如函数
fn foo(x: &i32) -> &i32,x参数的生命周期会被自动赋给返回值&i32,因此该函数等同于fn foo<'a>(x: &'a i32) -> &'a i32 -
若存在多个输入生命周期,且其中一个是
&self或&mut self,则&self的生命周期被赋给所有的输出生命周期- 这一规则说明方法不需要标注生命周期
- 如果方法中人为标注生命周期,有时会需要说明生命周期大小关系,详见https://course.rs/basic/lifetime.html#%E6%96%B9%E6%B3%95%E4%B8%AD%E7%9A%84%E7%94%9F%E5%91%BD%E5%91%A8%E6%9C%9F
如果不满足以上三条规则,说明编译器无法自行标注生命周期,因此需要我们人为标注生命周期
返回值和错误处理
- unwrap:如果返回成功,就将
Ok(T)中的值取出来,如果失败,就直接panic - expect在unwrap基础上,遇到错误直接
panic, 但是会带上自定义的错误提示信息
符号?相当于以下代码
符号?作用:
- 如果有值,对应
Ok(T)或Some<T>则返回对应的值,否则返回Err(e)或None(例1和例2) - 还可以链式调用(例3)
- ?还能够隐式实现错误类型的转换
初学者在用 ? 时,老是会犯错,例如写出这样的代码:
这段代码无法通过编译,切记:? 操作符需要一个变量来承载正确的值,这个函数只会返回 Some(&i32) 或者 None,只有错误值能直接返回,正确的值不行,所以如果数组中存在 0 号元素,那么函数第二行使用 ? 后的返回类型为 &i32 而不是 Some(&i32)。因此 ? 只能用于以下形式:
let v = xxx()?;xxx()?.yyy()?;
例1:可用于Result
let mut f = File::open("hello.txt")?;
// 等价于
let mut f = match f {
    // 打开文件成功,将file句柄赋值给f
    Ok(file) => file,
    // 打开文件失败,将错误返回(向上传播)
    Err(e) => return Err(e),
};
例2:也可用于Option
pub enum Option<T> {
    Some(T),
    None
}

fn first(arr: &[i32]) -> Option<&i32> {
   let v = arr.get(0)?;
   Some(v)
}
例3:
use std::fs::File;
use std::io;
use std::io::Read;

fn read_username_from_file() -> Result<String, io::Error> {
    let mut s = String::new();

    File::open("hello.txt")?.read_to_string(&mut s)?;

    Ok(s)
}
工程
基本指令
rust的源文件后缀为.rs
Cargo
cargo用于rust的项目
cargo生成文件简要介绍:
- cargo.toml为配置文件
- 不要修改cargo.lock
cargo.toml
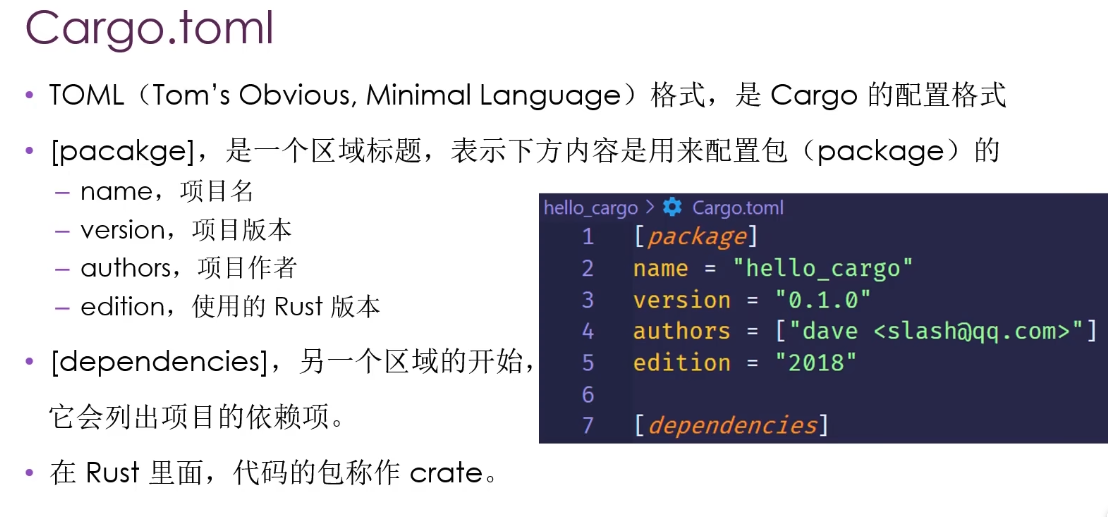
源代码放在src目录下
其余与程序源码无关文件放置在顶层目录(与toml同级)
cargo基本指令
cargo --version//检查cargo版本
cargo new hello_cargo//生成新的cargo项目
//进入cargo项目后
cargo build//编译rust的cargo项目
cargo run//编译并执行,若第一次已编译且编译后没有改动,则第二次直接执行
cargo check//检查代码,不生成可执行文件(开发时调试,比build快得多)
cargo build --release//用于发布,编译时会进行优化,代码运行更快,但编译时间更长
使用cargo build会在target/debug生成可执行文件
使用cargo build --release会在target/release生成可执行文件
cargo.lockc在第一次cargo build生成,记录当时的所有依赖项信息(包括版本),之后的build都按照lock里的依赖项
之后修改代码再build时,只会编译代码,不会编译依赖项