Go
Go语言特征
Go是强类型静态语言(编译语言)
内存消耗:
Java >> Go > Rust/C/C++
Go拥有运行时,用于垃圾回收,但是运行时显著小于Java
Hello,world
以上代码表明了go程序最基本的组成
package关键字表示包,Go 语言的代码通过包(package)组织,Go 语言的代码通过包(package)组织,包类似于其它语言里的库(libraries)或者模块(modules)。一个包由位于单个目录下的一个或多个.go源代码文件组成import表示导入外部包,不允许导入无用的包- 语句结尾不需要分号
Go语言基础
程序结构
命名
大写字母开头->可以被外部的包访问
小写字母开头->不可以被外部的包访问
驼峰式
变量
看几个例子就够了
基本使用
package main

import "fmt"

// var可用于全局变量
var globalX1 = 101

var globalX2 string = "abc"

func main(){
    // var也可用于局部变量
    var partialX = 100
    // :=只能用于局部变量
    partialY := 120
    fmt.Println(globalX1,globalX2,partialX,partialY)
}
多个变量声明
package main

import (
    "fmt"
)

func main() {
    var (
        s1      = "abc"
        s2      = "world"
        integer = 123
    )
    fmt.Println(s1)
    fmt.Println(s2)
    fmt.Println(integer)
}
另一个创建变量的方法是调用内建的new函数。表达式new(T)将创建一个T类型的匿名变量,初始化为T类型的零值,然后返回变量地址,返回的指针类型为*T。
p := new(int)   // p, *int 类型, 指向匿名的 int 变量
fmt.Println(*p) // "0"
*p = 2          // 设置 int 匿名变量的值为 2
fmt.Println(*p) // "2"
用new创建变量和普通变量声明语句方式创建变量没有什么区别,除了不需要声明一个临时变量的名字外,我们还可以在表达式中使用new(T)。换言之,new函数类似是一种语法糖,而不是一个新的基础概念。
进阶使用
例1: 符号:=为变量声明操作,符号=为变量赋值操作(将右边各个表达式的值赋值给左边对应位置的各个变量)
package main

import "fmt"

func main(){
    i := 1
    j := 2
    fmt.Println(i,j)
    // 交换两个变量的值
    i, j = j, i
    fmt.Println(i,j)
}

//output
//1 2
//2 1
例2:
简短变量声明左边的变量可能并不是全部都是刚刚声明的。如果有一些已经在相同的词法域声明过了(§2.7),那么简短变量声明语句对这些已经声明过的变量就只有赋值行为了。
在下面的代码中,第一个语句声明了in和err两个变量。在第二个语句只声明了out一个变量,然后对已经声明的err进行了赋值操作。
简短变量声明语句中必须至少要声明一个新的变量,下面的代码将不能编译通过:
解决的方法是第二个简短变量声明语句改用普通的多重赋值语句。
简短变量声明语句只有对已经在同级词法域声明过的变量才和赋值操作语句等价,如果变量是在外部词法域声明的,那么简短变量声明语句将会在当前词法域重新声明一个新的变量。
指针
指针和C基本相同,指针的零值在Go中为nil
唯一需要提醒的是,在Go语言中,返回函数中局部变量的地址也是安全的。例如下面的代码,调用f函数时创建局部变量v,在局部变量地址被返回之后依然有效,因为指针p依然引用这个变量。
每次调用f函数都将返回不同的结果:
这种情况在Rust中是不允许的(需要标注生命周期),Go允许是因为其特殊的垃圾回收机制
变量的生命周期(重要)
变量的生命周期指的是在程序运行期间变量有效存在的时间段。
对于在包一级声明的变量(全局变量)来说,它们的生命周期和整个程序的运行周期是一致的。
而相比之下,局部变量的生命周期则是动态的:每次从创建一个新变量的声明语句开始,直到该变量不再被引用为止(意思是,函数内部声明的局部变量,生命周期不一定只局限于当前函数,其生命周期可能比函数的还要大),然后变量的存储空间可能被回收。函数的参数变量和返回值变量都是局部变量。它们在函数每次被调用的时候创建。
以上涉及Go语言的垃圾回收机制(逃逸机制),在这里简单提一下:编译器会自动选择在栈上还是在堆上分配局部变量的存储空间,选择标准为:一个变量的有效周期只取决于是否可达
- 如果局部变量只在函数内部使用,则没有逃逸,在栈上分配内存
- 如果局部变量在函数内部使用后被返回给外部,且外部变量使用了这个局部变量,则逃逸,在堆上分配内存
具体关于Go的垃圾回收详见专题“Go原理“
赋值
只提一些容易忽略的
自增自减
数值变量也可以支持++递增和--递减语句(译注:自增和自减是语句,而不是表达式,因此x = i++之类的表达式是错误的):
元组赋值
元组赋值是另一种形式的赋值语句,它允许同时更新多个变量的值。在赋值之前,赋值语句右边的所有表达式将会先进行求值,然后再统一更新左边对应变量的值。这对于处理有些同时出现在元组赋值语句左右两边的变量很有帮助,例如我们可以这样交换两个变量的值:
或者是计算两个整数值的的最大公约数(GCD)(译注:Greatest Common Divisor的缩写,欧几里德的GCD是最早的非平凡算法):
或者是计算斐波纳契数列(Fibonacci)的第N个数:
元组赋值也可以使一系列琐碎赋值更加紧凑(译注: 特别是在for循环的初始化部分):
但如果表达式太复杂的话,应该尽量避免过度使用元组赋值;因为每个变量单独赋值语句的写法可读性会更好。
类型
一个类型声明语句创建了一个新的类型名称,和现有类型具有相同的底层结构。新命名的类型提供了一个方法,用来分隔不同概念的类型,这样即使它们底层类型相同也是不兼容的。
类型声明语句一般出现在包一级,因此如果新创建的类型名字的首字符大写,则在包外部也可以使用。
类型转换
相同底层类型的变量或者是两者都是指向相同底层结构的指针类型的类型转换:T(x),用于将x转为T类型(译注:如果T是指针类型,可能会需要用小括弧包装T,比如(*int)(0))。
这些转换只改变类型而不会影响值本身
其余转换可能会改变值
包和文件
每个包都对应一个独立的名字空间
包还可以让我们通过控制哪些名字是外部可见的来隐藏内部实现信息。在Go语言中,一个简单的规则是:如果一个名字是大写字母开头的,那么该名字是导出的
一个包的名字和包的导入路径的最后一个字段相同,例如gopl.io/ch2/tempconv包的名字一般是tempconv。在默认情况下,导入的包绑定到tempconv名字(译注:指包声明语句指定的名字),但是我们也可以绑定到另一个名称,以避免名字冲突
init函数
我们可以用一个特殊的init初始化函数来简化初始化工作。每个文件都可以包含多个init初始化函数
在每个文件中的init初始化函数,在程序开始执行时按照它们声明的顺序被自动调用。
每个包在解决依赖的前提下,以导入声明的顺序初始化,每个包只会被初始化一次。因此,如果一个p包导入了q包,那么在p包初始化的时候可以认为q包必然已经初始化过了。初始化工作是自下而上进行的,main包最后被初始化。以这种方式,可以确保在main函数执行之前,所有依赖的包都已经完成初始化工作了。
作用域
不要将作用域和生命周期混为一谈。
- 声明语句的作用域是指源代码中可以有效使用这个名字的范围,对应的是一个源代码的文本区域;它是一个编译时的属性。
- 一个变量的生命周期是指程序运行时变量存在的有效时间段,在此时间区域内它可以被程序的其他部分引用;是一个运行时的概念。
简单来说,作用域指名字的作用范围,如果作用域冲突,不能使用同一个名字;生命周期指变量的作用范围,关注的是变量的值什么时候有效
任何在函数外部(也就是包级语法域)声明的名字可以在同一个包的任何源文件中访问的。
对于导入的包,例如tempconv导入的fmt包,则是对应源文件级的作用域,因此只能在当前的文件中访问导入的fmt包,当前包的其它源文件无法访问在当前源文件导入的包。
需要注意for等语句的隐藏词法域(作用域)
下面的例子同样有三个不同的x变量,每个声明在不同的词法域,一个在函数体词法域,一个在for隐式的初始化词法域,一个在for循环体词法域;只有两个块是显式创建的:
func main() {
    x := "hello"
    for _, x := range x {
        x := x + 'A' - 'a'
        fmt.Printf("%c", x) // "HELLO" (one letter per iteration)
    }
}
和for循环类似,if和switch语句也会在条件部分创建隐式词法域,还有它们对应的执行体词法域。下面的if-else测试链演示了x和y的有效作用域范围:
if x := f(); x == 0 {
    fmt.Println(x)
} else if y := g(x); x == y {
    fmt.Println(x, y)
} else {
    fmt.Println(x, y)
}
fmt.Println(x, y) // compile error: x and y are not visible here
第二个if语句嵌套在第一个内部,因此第一个if语句条件初始化词法域声明的变量在第二个if中也可以访问。
switch语句的每个分支也有类似的词法域规则:条件部分为一个隐式词法域,然后是每个分支的词法域。
基础数据类型
整数类型
- 两种一般对应特定CPU平台机器字大小的有符号和无符号整数int和uint
- int8、int16、int32和int64
- uint8、uint16、uint32和uint64
Unicode字符rune类型是和int32等价的类型,通常用于表示一个Unicode码点。这两个名称可以互换使用。
byte也是uint8类型的等价类型,byte类型一般用于强调数值是一个原始的数据而不是一个小的整数。
无符号的整数类型uintptr,没有指定具体的bit大小但是足以容纳指针
数值类型的选择
数组的长度函数len()使用了有符号数
无符号数往往只有在位运算或其它特殊的运算场景才会使用,就像bit集合、分析二进制文件格式或者是哈希和加密操作等。
数值类型的转换
浮点数到整数的转换将丢失任何小数部分,然后向数轴零方向截断
浮点数/复数
没啥好说,这里不赘述
布尔值
注意一个点即可:布尔值并不会隐式转换为数字值0或1
字符串
编码方式
讲字符串之前,先介绍一下Go的编码方式
起码计算机世界就只有一个ASCII字符集:美国信息交换标准代码。ASCII,更准确地说是美国的ASCII,使用7bit来表示128个字符:包含英文字母的大小写、数字、各种标点符号和设备控制符。
但是ASCII的表示范围有限,为了表示世界上所有的符号,后面大家都使用Unicode。在Unicode中,每个字符对应唯一码点,范围为:从 0x0000 到 0x10FFFF。
通过十六进制数一眼看出多少个二进制位
- 每个十六进制数字对应 4 个二进制位:因为十六进制数的每一位可以表示 16 种状态(0-15),而 4 个二进制位可以表示 16 种状态(0000 到 1111)。
- 计算总位数:将十六进制数的位数乘以 4,即可得到对应的二进制位数。
0x10FFFF对应24个二进制位,因此通用的表示一个Unicode码点的数据类型是int32
Unicode有三种编码表示方式
- UTF-8:Unicode 的一种变长编码方式,它使用 1 到 4 个字节来表示一个字符。UTF-8 兼容 ASCII 编码,对于 ASCII 字符集中的字符,UTF-8 使用相同的单字节编码
- UTF-16
- UTF-32 :一种固定长度的编码方式,它使用 4 个字节来表示一个字符
rune类型
现在回到Go语言
在C语言中,表示一个字符采用的是char类型,对应的是ASCII编码
而Go语言采用了Unicode编码,表示一个字符采用的是rune类型,是int32的别名,这意味着它能表示一切符号系统。
并且Go表示Unicode的方式是采用了UTF-8编码。
采用了UTF-8编码是什么意思呢?
这意味着:
- 每个字符(rune类型)对应的字节长度不定(比如说,“世”字就需要三个字节表示,而"H"字符只需要一个字节)
- 字符串本质上是字节序列,因此字符串长度是字节序列长度,不是实际字符长度
- 如果要求字符串实际字符长度,需要使用rune或特定工具包
补充UTF-8一些信息:
UTF8编码使用1到4个字节来表示每个Unicode码点,ASCII部分字符只使用1个字节,常用字符部分使用2或3个字节表示。每个符号编码后第一个字节的高端bit位用于表示编码总共有多少个字节。如果第一个字节的高端bit为0,则表示对应7bit的ASCII字符,ASCII字符每个字符依然是一个字节,和传统的ASCII编码兼容。如果第一个字节的高端bit是110,则说明需要2个字节;后续的每个高端bit都以10开头。更大的Unicode码点也是采用类似的策略处理。
字符串
一个字符串是一个不可改变的字节序列。
内置的len函数可以返回一个字符串中的字节数目(不是rune字符数目),索引操作s[i]返回第i个字节的字节值,i必须满足0 ≤ i< len(s)条件约束。
子字符串操作s[i:j]基于原始的s字符串的第i个字节开始到第j个字节(并不包含j本身)生成一个新字符串。生成的新字符串将包含j-i个字节。
其中+操作符将两个字符串连接构造一个新字符串:
字符串可以用==和<进行比较;比较通过逐个字节比较完成的,因此比较的结果是字符串自然编码的顺序。
字符串的值是不可变的:一个字符串包含的字节序列永远不会被改变,当然我们也可以给一个字符串变量分配一个新字符串值。可以像下面这样将一个字符串追加到另一个字符串:
这并不会导致原始的字符串值被改变,但是变量s将因为+=语句持有一个新的字符串值,但是t依然是包含原先的字符串值。
因为字符串是不可修改的,因此尝试修改字符串内部数据的操作也是被禁止的:
得益于UTF8编码优良的设计,诸多字符串操作都不需要解码操作。我们可以不用解码直接测试一个字符串是否是另一个字符串的前缀:
或者是后缀测试:
func HasSuffix(s, suffix string) bool {
    return len(s) >= len(suffix) && s[len(s)-len(suffix):] == suffix
}
或者是包含子串测试:
func Contains(s, substr string) bool {
    for i := 0; i < len(s); i++ {
        if HasPrefix(s[i:], substr) {
            return true
        }
    }
    return false
}
字符串字节序列和实际字符序列转换
- 使用unicode/utf8包
- RuneCountInString(s)可以获得实际字符个数
- utf8.DecodeRuneInString(s)从字符串中解码第一个有效的 UTF-8 编码的 Unicode 字符
- 每一次调用DecodeRuneInString函数都返回一个r和长度,r对应字符本身,长度对应r采用UTF8编码后的编码字节数目。
import "unicode/utf8"

s := "Hello, 世界"
fmt.Println(len(s))                    // "13"
fmt.Println(utf8.RuneCountInString(s)) // "9"

for i := 0; i < len(s); {
    r, size := utf8.DecodeRuneInString(s[i:])
    fmt.Printf("%d\t%c\n", i, r)
    i += size
}
//output
0       H
1       e
2       l
3       l
4       o
5       ,
6
7       世
10      界
Go语言的range循环在处理字符串的时候,会自动隐式解码UTF8字符串。
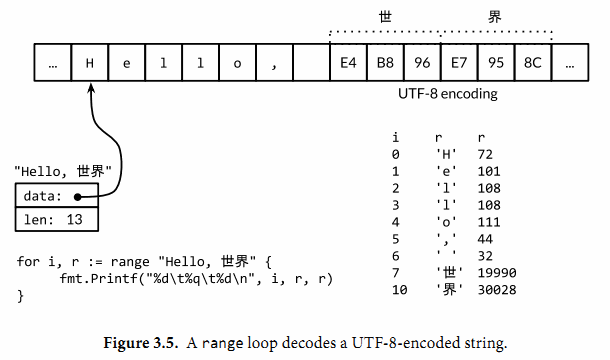
- []rune类型和string类型转换
将[]rune类型转换应用到UTF8编码的字符串,将返回字符串编码的Unicode码点序列:
// "program" in Japanese katakana
s := "プログラム"
fmt.Printf("% x\n", s) // "e3 83 97 e3 83 ad e3 82 b0 e3 83 a9 e3 83 a0"
r := []rune(s)
fmt.Printf("%x\n", r)  // "[30d7 30ed 30b0 30e9 30e0]"
(在第一个Printf中的% x参数用于在每个十六进制数字前插入一个空格。)
如果是将一个[]rune类型的Unicode字符slice或数组转为string,则对它们进行UTF8编码:
将一个整数转型为字符串意思是生成以只包含对应Unicode码点字符的UTF8字符串:
如果对应码点的字符是无效的,则用\uFFFD无效字符作为替换:
字符串面值
形式为"...."的字符串面值,可以包含转义字符
形式为'....'的字符串面值,称为原生字符串面值,不含转义操作。如下例,换行等都是不通过转义字符实现
原生字符串面值用于编写正则表达式会很方便,因为正则表达式往往会包含很多反斜杠。原生字符串面值同时被广泛应用于HTML模板、JSON面值、命令行提示信息以及那些需要扩展到多行的场景。
字符串底层原理
一个字符串s和对应的子字符串切片s[7:]共享相同内存,如下图
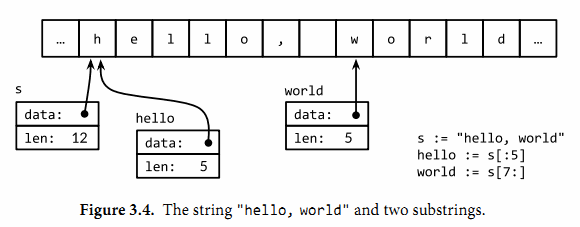
字符串相关包
标准库中有四个包对字符串处理尤为重要:bytes、strings、strconv和unicode包。
- strings包提供了许多如字符串的查询、替换、比较、截断、拆分和合并等功能。
- bytes包也提供了很多类似功能的函数,但是针对和字符串有着相同结构的[]byte类型。因为字符串是只读的,因此逐步构建字符串会导致很多分配和复制。在这种情况下,使用bytes.Buffer类型将会更有效,稍后我们将展示。
- strconv包提供了布尔型、整型数、浮点数和对应字符串的相互转换,还提供了双引号转义相关的转换。
- unicode包提供了IsDigit、IsLetter、IsUpper和IsLower等类似功能,它们用于给字符分类。每个函数有一个单一的rune类型的参数,然后返回一个布尔值。而像ToUpper和ToLower之类的转换函数将用于rune字符的大小写转换。所有的这些函数都是遵循Unicode标准定义的字母、数字等分类规范。strings包也有类似的函数,它们是ToUpper和ToLower,将原始字符串的每个字符都做相应的转换,然后返回新的字符串。
字符串与字节slice之间相互转换
字符串和字节slice之间可以相互转换:
从概念上讲,一个[]byte(s)转换是分配了一个新的字节数组用于保存字符串数据的拷贝,然后引用这个底层的字节数组。
编译器的优化可以避免在一些场景下分配和复制字符串数据,但总的来说需要确保在变量b被修改的情况下,原始的s字符串也不会改变。将一个字节slice转换到字符串的string(b)操作则是构造一个字符串拷贝,以确保s2字符串是只读的。
bytes包还提供了Buffer类型用于字节slice的缓存。一个Buffer开始是空的,但是随着string、byte或[]byte等类型数据的写入可以动态增长,一个bytes.Buffer变量并不需要初始化,因为零值也是有效的
字符串和数字的转换
整数转为字符串
将一个整数转为字符串,有两种方法
- 一种方法是用fmt.Sprintf返回一个格式化的字符串;
- 另一个方法是用strconv.Itoa(“整数到ASCII”):
FormatInt和FormatUint函数可以用不同的进制来格式化数字:
fmt.Printf函数的%b、%d、%o和%x等参数提供功能往往比strconv包的Format函数方便很多,特别是在需要包含有附加额外信息的时候:
字符串解析为整数
如果要将一个字符串解析为整数,可以使用strconv包的Atoi或ParseInt函数,还有用于解析无符号整数的ParseUint函数:
x, err := strconv.Atoi("123")             // x is an int
y, err := strconv.ParseInt("123", 10, 64) // base 10, up to 64 bits
ParseInt函数的第三个参数是用于指定整型数的大小;例如16表示int16,0则表示int。在任何情况下,返回的结果y总是int64类型,你可以通过强制类型转换将它转为更小的整数类型。
有时候也会使用fmt.Scanf来解析输入的字符串和数字,特别是当字符串和数字混合在一行的时候,它可以灵活处理不完整或不规则的输入。
常量
和变量声明类似,Go常量声明没有规定需要标注类型,即编译器可以自行推断
常量的值在编译时计算并确定,常量值不可修改(因此可以指定数组类型的长度)
单个声明
和变量声明一样,可以批量声明多个常量;这比较适合声明一组相关的常量:
const (
    e  = 2.71828182845904523536028747135266249775724709369995957496696763
    pi = 3.14159265358979323846264338327950288419716939937510582097494459
)
iota常量生成器
常量声明可以使用iota常量生成器初始化,它用于生成一组以相似规则初始化的常量,但是不用每行都写一遍初始化表达式。在一个const声明语句中,在第一个声明的常量所在的行,iota将会被置为0,然后在每一个有常量声明的行加一。
下面是来自time包的例子,它首先定义了一个Weekday命名类型,然后为一周的每天定义了一个常量,从周日0开始。在其它编程语言中,这种类型一般被称为枚举类型。
周日将对应0,周一为1,如此等等。
复合数据结构
数组
每个元素都有相同的类型
定长数组
形如var a [3]int
内置的len函数将返回数组中元素的个数。
数组的长度需要在编译阶段确定(数组的长度必须是常量表达式)
初始化
以下展示了多种初始化方法
package main

import (
    "fmt"
)

func main() {
    var arr0 [3]int = [3]int{1, 2, 3}

    var arr1 [3]int
    arr1[0] = 1
    arr1[1] = 2
    arr1[2] = 3

    arr2 := [3]int{}
    arr2[0] = 1
    arr2[1] = 2
    arr2[2] = 3

    arr3 := [3]int{1, 2, 3}

    arr4 := [...]int{1, 2, 3}

    fmt.Println(arr0)
    fmt.Println(arr1)
    fmt.Println(arr2)
    fmt.Println(arr3)
    fmt.Println(arr4)
}
在数组字面值中,如果在数组的长度位置出现的是“...”省略号,则表示数组的长度是根据初始化值的个数来计算。因此,上面q数组的定义可以简化为
定义了一个含有100个元素的数组r,最后一个元素被初始化为-1,其它元素都是用0初始化。
和C类似,数组的指针可以使用索引,如下:
package main

import (
    "fmt"
)

func modifyArray(ptr *[32]byte) {
    var cnt byte = 1
    for i := range ptr {
        ptr[i] = cnt
        cnt++
    }
}

func main() {
    ptr := &[32]byte{}
    fmt.Println(ptr)
    modifyArray(ptr)
    fmt.Println(ptr)
}
变长数组:切片Slice
slice三要素
形如var a []int或s[i:j]
是数组对象的引用,由三个部分构成:指针、长度和容量
- 指针指向第一个slice元素对应的底层数组元素的地址,要注意的是slice的第一个元素并不一定就是数组的第一个元素。
- 长度对应slice中元素的数目;长度不能超过容量
- 容量一般是从slice的开始位置到底层数据的结尾位置。
内置的len和cap函数分别返回slice的长度和容量。
package main

import "fmt"

func main() {
    s := [10]int{0, 1, 2, 3, 4, 5, 6, 7, 8, 9}
    t := s[2:5]
    fmt.Println(len(t))
    fmt.Println(cap(t))
}

//output: 3 8
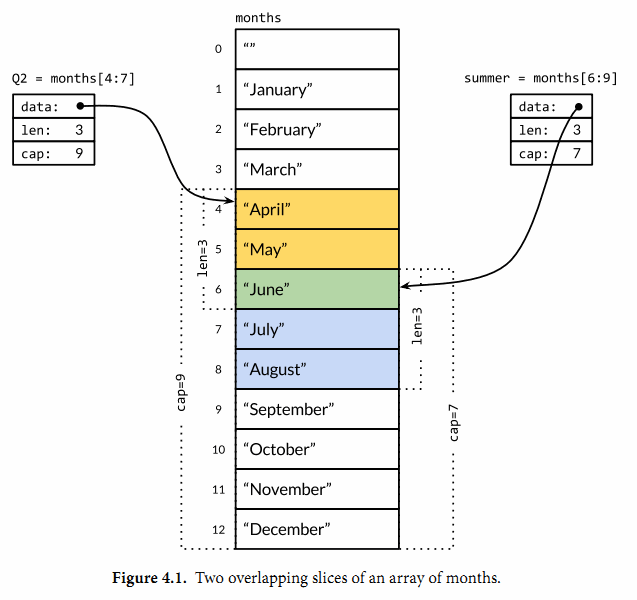
如果切片操作超出cap(s)的上限将导致一个panic异常,但是超出len(s)则是意味着扩展了slice,因为新slice的长度会变大:
package main

import "fmt"

func main() {
    s := [10]int{0, 1, 2, 3, 4, 5, 6, 7, 8, 9}
    t := s[2:5]
    fmt.Println(len(t)) // 3
    fmt.Println(cap(t)) // 8
  // len(t) + 1超出了原切片t的len
    p := t[:len(t)+1]
    fmt.Println(len(p)) // 4
    fmt.Println(cap(p)) // 8
    fmt.Println(p) // 2 3 4 5
}
因为slice值包含指向第一个slice元素的指针,因此向函数传递slice将允许在函数内部修改底层数组的元素。换句话说,复制一个slice只是对底层的数组创建了一个新的slice别名。
下面的reverse函数在原内存空间将[]int类型的slice反转,而且它可以用于任意长度的slice。
// reverse reverses a slice of ints in place.
func reverse(s []int) {
    for i, j := 0, len(s)-1; i < j; i, j = i+1, j-1 {
        s[i], s[j] = s[j], s[i]
    }
}
使用make创建slice
内置的make函数创建一个指定元素类型、长度和容量的slice。容量部分可以省略,在这种情况下,容量将等于长度。
在底层,make创建了一个匿名的数组变量,然后返回一个slice;只有通过返回的slice才能引用底层匿名的数组变量。在第一种语句中,slice是整个数组的view。在第二个语句中,slice只引用了底层数组的前len个元素,但是容量将包含整个的数组。额外的元素是留给未来的增长用的。
slice的比较
和数组不同的是,slice之间不能比较,因此我们不能使用==操作符来判断两个slice是否含有全部相等元素。不过标准库提供了高度优化的bytes.Equal函数来判断两个字节型slice是否相等([]byte),但是对于其他类型的slice,我们必须自己展开每个元素进行比较:
func equal(x, y []string) bool {
    if len(x) != len(y) {
        return false
    }
    for i := range x {
        if x[i] != y[i] {
            return false
        }
    }
    return true
}
slice唯一合法的比较操作是和nil比较,例如:
slice的特殊值
零值:
- 一个零值的slice等于nil。
- 一个nil值的slice并没有底层数组。
- 一个nil值的slice的长度和容量都是0
非零值但是长度和容量为0
- 例如[]int{}
- 例如make([]int, 3)[3:]
var s []int    // len(s) == 0, s == nil
s = nil        // len(s) == 0, s == nil
s = []int(nil) // len(s) == 0, s == nil
s = []int{}    // len(s) == 0, s != nil
如果需要测试一个slice是否是空的,使用len(s) == 0来判断
append函数
具体看这个
https://golang-china.github.io/gopl-zh/ch4/ch4-02.html#:~:text=4.2.1.%20append-,%E5%87%BD%E6%95%B0,-%E5%86%85%E7%BD%AE%E7%9A%84
调用方法:
我们不能确认新的slice和原始的slice是否引用的是相同的底层数组空间。同样,我们不能确认在原先的slice上的操作是否会影响到新的slice。因此,通常是将append返回的结果直接赋值给输入的slice变量:
内置的append函数则可以追加多个元素,甚至追加一个slice。
var x []int
x = append(x, 1)
x = append(x, 2, 3)
x = append(x, 4, 5, 6)
x = append(x, x...) // append the slice x
fmt.Println(x)      // "[1 2 3 4 5 6 1 2 3 4 5 6]"
slice的应用
对于slice等引用类型,通常采用新slice = function(旧slice, 其他参数)的方法调用函数
如下例:
下面的nonempty函数将在原有slice内存空间之上返回不包含空字符串的列表:
gopl.io/ch4/nonempty
// Nonempty is an example of an in-place slice algorithm.
package main

import "fmt"

// nonempty returns a slice holding only the non-empty strings.
// The underlying array is modified during the call.
func nonempty(strings []string) []string {
    i := 0
    for _, s := range strings {
        if s != "" {
            strings[i] = s
            i++
        }
    }
    return strings[:i]
}
比较微妙的地方是,输入的slice和输出的slice共享一个底层数组。这可以避免分配另一个数组,不过原来的数据将可能会被覆盖,正如下面两个打印语句看到的那样:
data := []string{"one", "", "three"}
fmt.Printf("%q\n", nonempty(data)) // `["one" "three"]`
fmt.Printf("%q\n", data)           // `["one" "three" "three"]`
因此我们通常会这样使用nonempty函数:data = nonempty(data)。
slice模拟栈
一个slice可以用来模拟一个stack。最初给定的空slice对应一个空的stack,然后可以使用append函数将新的值压入stack:
stack的顶部位置对应slice的最后一个元素:
通过收缩stack可以弹出栈顶的元素
要删除slice中间的某个元素并保存原有的元素顺序,可以通过内置的copy函数将后面的子slice向前依次移动一位完成:
func remove(slice []int, i int) []int {
    copy(slice[i:], slice[i+1:])
    return slice[:len(slice)-1]
}

func main() {
    s := []int{5, 6, 7, 8, 9}
    fmt.Println(remove(s, 2)) // "[5 6 8 9]"
}
如果删除元素后不用保持原来顺序的话,我们可以简单的用最后一个元素覆盖被删除的元素:
func remove(slice []int, i int) []int {
    slice[i] = slice[len(slice)-1]
    return slice[:len(slice)-1]
}

func main() {
    s := []int{5, 6, 7, 8, 9}
    fmt.Println(remove(s, 2)) // "[5 6 9 8]
}
Map
在Go语言中,一个map就是一个哈希表的引用,map类型可以写为map[K]V,其中K和V分别对应key和value。map中所有的key都有相同的类型,所有的value也有着相同的类型,但是key和value之间可以是不同的数据类型。其中K对应的key必须是支持==比较运算符的数据类型,所以map可以通过测试key是否相等来判断是否已经存在。
Map的初始化
方法一
方法二
零值
map类型的零值是nil,也就是没有引用任何哈希表
基本操作
所有这些操作是安全的,即使这些元素不在map中也没有关系
访问
Map中的元素通过key对应的下标语法访问:
通过key作为索引下标来访问map将产生一个value。如果key在map中是存在的,那么将得到与key对应的value;如果key不存在,那么将得到value对应类型的零值
如果想要知道对应的元素是否真的是在map之中
你会经常看到将这两个结合起来使用,像这样:
但是map中的元素并不是一个变量,因此我们不能对map的元素进行取址操作:
禁止对map元素取址的原因是map可能随着元素数量的增长而重新分配更大的内存空间,从而可能导致之前的地址无效。
删除元素
使用内置的delete函数可以删除元素:
遍历
Map的迭代顺序是不确定的
如果要按顺序遍历key/value对,我们必须显式地对key进行排序,可以使用sort包的Strings函数对字符串slice进行排序。下面是常见的处理方式:
import "sort"

var names []string
for name := range ages {
    names = append(names, name)
}
sort.Strings(names)
for _, name := range names {
    fmt.Printf("%s\t%d\n", name, ages[name])
}
因为我们一开始就知道names的最终大小,因此给slice分配一个合适的大小将会更有效。下面的代码创建了一个空的slice,但是slice的容量刚好可以放下map中全部的key:
比较
和slice一样,map之间也不能进行相等比较;唯一的例外是和nil进行比较。要判断两个map是否包含相同的key和value,我们必须通过一个循环实现:
func equal(x, y map[string]int) bool {
    if len(x) != len(y) {
        return false
    }
    for k, xv := range x {
        if yv, ok := y[k]; !ok || yv != xv {
            return false
        }
    }
    return true
}
如果key想要是slice等不可比较的类型
我们可以通过两个步骤绕过这个限制。
- 定义一个辅助函数k,将slice转为map对应的string类型的key,确保只有x和y相等时k(x) == k(y)才成立。
- 创建一个key为string类型的map,在每次对map操作时先用k辅助函数将slice转化为string类型。
下面的例子演示了如何使用map来记录提交相同的字符串列表的次数。它使用了fmt.Sprintf函数将字符串列表转换为一个字符串以用于map的key,通过%q参数忠实地记录每个字符串元素的信息:
var m = make(map[string]int)

func k(list []string) string { return fmt.Sprintf("%q", list) }

func Add(list []string)       { m[k(list)]++ }
func Count(list []string) int { return m[k(list)] }
结构体
访问
与Map不同,结构体成员可以取地址,然后通过指针访问:
position := &dilbert.Position
*position = "Senior " + *position // promoted, for outsourcing to Elbonia
相当于下面语句
成员
如果结构体成员名字是以大写字母开头的,那么该成员就是导出的
结构体成员的输入顺序也有重要的意义。
结构体类型的零值是每个成员都是零值。通常会将零值作为最合理的默认值。
如果结构体没有任何成员的话就是空结构体,写作struct{}。它的大小为0,也不包含任何信息
初始化
方法一:按顺序初始化
方法二:指定名字和值初始化
如果成员被忽略的话将默认用零值。因为提供了成员的名字,所以成员出现的顺序并不重要。
两种不同形式的写法不能混合使用。而且,你不能企图在外部包中用第一种顺序赋值的技巧来偷偷地初始化结构体中未导出的成员。
比较
如果结构体的全部成员都是可以比较的,那么结构体也是可以比较的,那样的话两个结构体将可以使用==或!=运算符进行比较。相等比较运算符==将比较两个结构体的每个成员,因此下面两个比较的表达式是等价的:
type Point struct{ X, Y int }

p := Point{1, 2}
q := Point{2, 1}
fmt.Println(p.X == q.X && p.Y == q.Y) // "false"
fmt.Println(p == q) // "false"
可比较的结构体类型和其他可比较的类型一样,可以用于map的key类型。
type address struct {
    hostname string
    port     int
}

hits := make(map[address]int)
hits[address{"golang.org", 443}]++
嵌入和匿名结构体
匿名结构体
顾名思义,就是没有名字的结构体,适用于只使用一次结构体(声明之后需要立即初始化)的情况
【例1: 匿名结构体和有名结构体的初始化】
package main

import "fmt"

type Student struct {
    name string
    age  int
}

func main() {
    // 匿名结构体
    mike := struct {
        name string
        age  int
    }{
        name: "mike",
        age:  18,
    }

    // 有名结构体
    amy := Student{
        name: "amy",
        age:  21,
    }
    fmt.Println(mike)
    fmt.Println(amy)
}
【例2: 匿名结构体和有名结构体作为成员嵌套在结构体中】
有名结构体嵌套
type Student struct {
    stuNo string
    name  string
    age   int
}

type Teacher struct {
    teaNo string
    name  string
    age   int
}

type Class struct {
    student Student
    teacher Teacher
}
匿名结构体嵌套
type Class struct {
    student struct {
        stuNo string
        name  string
        age   int
    }
    teacher struct {
        teaNo string
        name  string
        age   int
    }
}
前面提到匿名结构体只用于使用一次的场景,因此它的初始化长这样
type Class struct {
    student struct {
        stuNo string
        name  string
        age   int
    }
    teacher struct {
        teaNo string
        name  string
        age   int
    }
}

func main() {
    // 匿名结构体
    class101 := Class{
        student: struct {
            stuNo string
            name  string
            age   int
        }{
            stuNo: "001",
            name:  "mike",
            age:   18,
        },
        teacher: struct {
            teaNo string
            name  string
            age   int
        }{
            teaNo: "1001",
            name:  "Dr. Zhang",
            age:   21,
        },
    }
    fmt.Println(class101)
}
可以发现代码比较不方便,建议不要在有名结构体成员中使用匿名结构体,否则会导致使用有名结构体的时候重新声明和初始化匿名结构体
嵌入结构体
适用于重复成员声明导致访问成员变得繁琐的情况
考虑一个二维的绘图程序,提供了一个各种图形的库,例如矩形、椭圆形、星形和轮形等几何形状。这里是其中两个的定义:
一个Circle代表的圆形类型包含了标准圆心的X和Y坐标信息,和一个Radius表示的半径信息。一个Wheel轮形除了包含Circle类型所有的全部成员外,还增加了Spokes表示径向辐条的数量。我们可以这样创建一个wheel变量:
随着库中几何形状数量的增多,我们一定会注意到它们之间的相似和重复之处,所以我们可能为了便于维护而将相同的属性独立出来:
type Point struct {
    X, Y int
}

type Circle struct {
    Center Point
    Radius int
}

type Wheel struct {
    Circle Circle
    Spokes int
}
这样改动之后结构体类型变的清晰了,但是这种修改同时也导致了访问每个成员变得繁琐:
Go语言有一个特性让我们只声明一个成员对应的数据类型而不指名成员的名字;这类成员就叫匿名成员(与匿名结构体区分开)。匿名成员的数据类型必须是命名的类型或指向一个命名的类型的指针。下面的代码中,Circle和Wheel各自都有一个匿名成员。我们可以说Point类型被嵌入到了Circle结构体,同时Circle类型被嵌入到了Wheel结构体。
得益于匿名嵌入的特性,我们可以直接访问叶子属性而不需要给出完整的路径:
var w Wheel
w.X = 8            // equivalent to w.Circle.Point.X = 8
w.Y = 8            // equivalent to w.Circle.Point.Y = 8
w.Radius = 5       // equivalent to w.Circle.Radius = 5
w.Spokes = 20
在右边的注释中给出的显式形式访问这些叶子成员的语法依然有效,因此匿名成员并不是真的无法访问了。其中匿名成员Circle和Point都有自己的名字——就是命名的类型名字——但是这些名字在点操作符中是可选的。我们在访问子成员的时候可以忽略任何匿名成员部分。
不幸的是,结构体字面值并没有简短表示匿名成员的语法, 因此下面的语句都不能编译通过:
w = Wheel{8, 8, 5, 20}                       // compile error: unknown fields
w = Wheel{X: 8, Y: 8, Radius: 5, Spokes: 20} // compile error: unknown fields
结构体字面值必须遵循形状类型声明时的结构,所以我们只能用下面的两种语法,它们彼此是等价的:
w = Wheel{Circle{Point{8, 8}, 5}, 20}

w = Wheel{
    Circle: Circle{
        Point:  Point{X: 8, Y: 8},
        Radius: 5,
    },
    Spokes: 20, // NOTE: trailing comma necessary here (and at Radius)
}

fmt.Printf("%#v\n", w)
// Output:
// Wheel{Circle:Circle{Point:Point{X:8, Y:8}, Radius:5}, Spokes:20}

w.X = 42

fmt.Printf("%#v\n", w)
// Output:
// Wheel{Circle:Circle{Point:Point{X:42, Y:8}, Radius:5}, Spokes:20}
需要注意的是Printf函数中%v参数包含的#副词,它表示用和Go语言类似的语法打印值。对于结构体类型来说,将包含每个成员的名字。
因为匿名成员也有一个隐式的名字,因此不能同时包含两个类型相同的匿名成员,这会导致名字冲突。同时,因为成员的名字是由其类型隐式地决定的,所以匿名成员也有可见性的规则约束。在上面的例子中,Point和Circle匿名成员都是导出的。即使它们不导出(比如改成小写字母开头的point和circle),我们依然可以用简短形式访问匿名成员嵌套的成员
但是在包外部,因为circle和point没有导出,不能访问它们的成员,因此简短的匿名成员访问语法也是禁止的。
Json
encoding/json包
json数组类型对应go的数组或slice
json对象类型对应go的结构体或map
结构体数组转换为Json
将一个Go语言中类似movies的结构体slice转为JSON的过程叫编组(marshaling)。
json.Marshal
编组通过调用json.Marshal函数完成:
data, err := json.Marshal(movies)
if err != nil {
    log.Fatalf("JSON marshaling failed: %s", err)
}
fmt.Printf("%s\n", data)
Marshal函数返回一个编码后的字节slice,包含很长的字符串,并且没有空白缩进;我们将它折行以便于显示:
[{"Title":"Casablanca","released":1942,"Actors":["Humphrey Bogart","Ingr
id Bergman"]},{"Title":"Cool Hand Luke","released":1967,"color":true,"Ac
tors":["Paul Newman"]},{"Title":"Bullitt","released":1968,"color":true,"
Actors":["Steve McQueen","Jacqueline Bisset"]}]
这种紧凑的表示形式虽然包含了全部的信息,但是很难阅读。
json.MarshalIndent
json.MarshalIndent函数将产生整齐缩进的输出。该函数有两个额外的字符串参数用于表示每一行输出的前缀和每一个层级的缩进:
data, err := json.MarshalIndent(movies, "", "    ")
if err != nil {
    log.Fatalf("JSON marshaling failed: %s", err)
}
fmt.Printf("%s\n", data)
上面的代码将产生这样的输出(译注:在最后一个成员或元素后面并没有逗号分隔符):
[
    {
        "Title": "Casablanca",
        "released": 1942,
        "Actors": [
            "Humphrey Bogart",
            "Ingrid Bergman"
        ]
    },
    {
        "Title": "Cool Hand Luke",
        "released": 1967,
        "color": true,
        "Actors": [
            "Paul Newman"
        ]
    },
    {
        "Title": "Bullitt",
        "released": 1968,
        "color": true,
        "Actors": [
            "Steve McQueen",
            "Jacqueline Bisset"
        ]
    }
]
Tag
一个结构体成员Tag是和在编译阶段关联到该成员的元信息字符串
用人话说就是,tag里的第一个值对应json的名字,其余值对应其他信息
例如Tag还包含omitempty选项,表示当Go语言结构体成员为空或零值时不生成该JSON对象(这里false为零值)。
Json转换为Go数据结构
Go语言中一般叫unmarshaling,通过json.Unmarshal函数完成。
通过定义合适的Go语言数据结构,我们可以选择性地解码JSON中感兴趣的成员。当Unmarshal函数调用返回,slice将被只含有Title信息的值填充,其它JSON成员将被忽略。
var titles []struct{ Title string }
if err := json.Unmarshal(data, &titles); err != nil {
    log.Fatalf("JSON unmarshaling failed: %s", err)
}
fmt.Println(titles) // "[{Casablanca} {Cool Hand Luke} {Bullitt}]"
控制结构
https://juejin.cn/post/7104462078013866015
If语句
可以改写为
改写之后,length只在if语句内生效
函数
go函数按值传递参数,没有引用传递
如果参数传的是参数,go传递数组的拷贝(有的语言会隐式地将数组作为引用或指针对象传入被调用的函数)
关于返回值,如下形式,是可以运行的(返回x,y),它表明了:返回值x, y在函数体内初始化为零值,因此整个函数体内都可以使用x, y
对于复合数据类型(尤其是map和struct),需要传递指针才能修改原结构,否则是值拷贝(副本)
如果实参包括引用类型,如指针,slice(切片)、map、function、channel等类型,实参可能会由于函数的间接引用被修改。
错误处理
与Java不同,Go拥有独特的错误处理机制。Go将可预料的错误视作值处理,将不可预料的错误当作异常
Go这样设计的原因是由于对于某个应该在控制流程中处理的错误而言,将这个错误以异常的形式抛出会混乱对错误的描述,这通常会导致一些糟糕的后果。当某个程序错误被当作异常处理后,这个错误会将堆栈跟踪信息返回给终端用户,这些信息复杂且无用,无法帮助定位错误。
直接返回错误
最常用的方式是传播错误。这意味着函数中某个子程序的失败,会变成该函数的失败。
下面,我们以findLinks函数作为例子。如果findLinks对http.Get的调用失败,findLinks会直接将这个HTTP错误返回给调用者:
补充错误信息再返回
一般而言,被调用函数f(x)会将调用信息和参数信息作为发生错误时的上下文放在错误信息中并返回给调用者,调用者需要添加一些错误信息中不包含的信息。
如下例,当对html.Parse的调用失败时,findLinks不会直接返回html.Parse的错误,因为缺少两条重要信息:
- 发生错误时的解析器(html parser);
- 发生错误的url。
因此,findLinks构造了一个新的错误信息,既包含了这两项,也包括了底层的解析出错的信息。
doc, err := html.Parse(resp.Body)
resp.Body.Close()
if err != nil {
    return nil, fmt.Errorf("parsing %s as HTML: %v", url,err)
}
fmt.Errorf函数使用fmt.Sprintf格式化错误信息并返回。我们使用该函数添加额外的前缀上下文信息到原始错误信息。当错误最终由main函数处理时,错误信息应提供清晰的从原因到后果的因果链,就像美国宇航局事故调查时做的那样:
由于错误信息经常是以链式组合在一起的,所以错误信息中应避免大写和换行符。最终的错误信息可能很长,我们可以通过类似grep的工具处理错误信息
重新尝试
如果错误的发生是偶然性的,或由不可预知的问题导致的。一个明智的选择是重新尝试失败的操作。在重试时,我们需要限制重试的时间间隔或重试的次数,防止无限制的重试。
// WaitForServer attempts to contact the server of a URL.
// It tries for one minute using exponential back-off.
// It reports an error if all attempts fail.
func WaitForServer(url string) error {
    const timeout = 1 * time.Minute
    deadline := time.Now().Add(timeout)
    for tries := 0; time.Now().Before(deadline); tries++ {
        _, err := http.Head(url)
        if err == nil {
            return nil // success
        }
        log.Printf("server not responding (%s);retrying…", err)
        time.Sleep(time.Second << uint(tries)) // exponential back-off
    }
    return fmt.Errorf("server %s failed to respond after %s", url, timeout)
}
输出错误信息并结束程序
这种策略只应在main中执行,对库函数而言,应仅向上传播错误,除非该错误意味着程序内部包含不一致性,即遇到了bug,才能在库函数中结束程序。
// (In function main.)
if err := WaitForServer(url); err != nil {
    fmt.Fprintf(os.Stderr, "Site is down: %v\n", err)
    os.Exit(1)
}
调用log.Fatalf可以更简洁的代码达到与上文相同的效果。log中的所有函数,都默认会在错误信息之前输出时间信息。
只输出错误信息,不中断程序执行
有时,我们只需要输出错误信息就足够了,不需要中断程序的运行。我们可以通过log包提供函数
或者标准错误流输出错误信息。
if err := Ping(); err != nil {
    fmt.Fprintf(os.Stderr, "ping failed: %v; networking disabled\n", err)
}
log包中的所有函数会为没有换行符的字符串增加换行符。
直接忽略错误
dir, err := ioutil.TempDir("", "scratch")
if err != nil {
    return fmt.Errorf("failed to create temp dir: %v",err)
}
// ...use temp dir…
os.RemoveAll(dir) // ignore errors; $TMPDIR is cleaned periodically
尽管os.RemoveAll会失败,但上面的例子并没有做错误处理。这是因为操作系统会定期的清理临时目录。正因如此,虽然程序没有处理错误,但程序的逻辑不会因此受到影响。我们应该在每次函数调用后,都养成考虑错误处理的习惯,当你决定忽略某个错误时,你应该清晰地写下你的意图。
在Go中,错误处理有一套独特的编码风格。检查某个子函数是否失败后,我们通常将处理失败的逻辑代码放在处理成功的代码之前。如果某个错误会导致函数返回,那么成功时的逻辑代码不应放在else语句块中,而应直接放在函数体中。Go中大部分函数的代码结构几乎相同,首先是一系列的初始检查,防止错误发生,之后是函数的实际逻辑。
文件结尾错误(EOF)
函数经常会返回多种错误,这对终端用户来说可能会很有趣,但对程序而言,这使得情况变得复杂。很多时候,程序必须根据错误类型,作出不同的响应。让我们考虑这样一个例子:从文件中读取n个字节。如果n等于文件的长度,读取过程的任何错误都表示失败。如果n小于文件的长度,调用者会重复的读取固定大小的数据直到文件结束。这会导致调用者必须分别处理由文件结束引起的各种错误。基于这样的原因,io包保证任何由文件结束引起的读取失败都返回同一个错误——io.EOF,该错误在io包中定义:
package io

import "errors"

// EOF is the error returned by Read when no more input is available.
var EOF = errors.New("EOF")
调用者只需通过简单的比较,就可以检测出这个错误。下面的例子展示了如何从标准输入中读取字符,以及判断文件结束。
in := bufio.NewReader(os.Stdin)
for {
    r, _, err := in.ReadRune()
    if err == io.EOF {
        break // finished reading
    }
    if err != nil {
        return fmt.Errorf("read failed:%v", err)
    }
    // ...use r…
}
函数值(闭包)
闭包的概念详见:https://juejin.cn/post/7084549768067678245
Go 语言中的函数也是一种值,拥有类型,可以被传递,跟 C++ 函数对象、 Python 函数类似。
func square(n int) int { return n * n }
    func negative(n int) int { return -n }
    func product(m, n int) int { return m * n }

    f := square
    fmt.Println(f(3)) // "9"

    f = negative
    fmt.Println(f(3))     // "-3"
    fmt.Printf("%T\n", f) // "func(int) int"

    f = product // compile error: can't assign func(int, int) int to func(int) int
函数类型的零值是nil。调用值为nil的函数值会引起panic错误:
函数值可以与nil比较:
但是函数值之间是不可比较的,也不能用函数值作为map的key。
详见https://golang-china.github.io/gopl-zh/ch5/ch5-05.html
匿名函数
匿名函数,又叫函数字面量
拥有函数名的函数只能在包级语法块中被声明,通过函数字面量(function literal),我们可绕过这一限制,在任何表达式中表示一个函数值。
函数字面量的语法和函数声明相似,区别在于func关键字后没有函数名。函数值字面量是一种表达式,它的值被称为匿名函数(anonymous function)。
函数字面量允许我们在使用函数时,再定义它。
通过这种方式定义的函数可以访问完整的词法环境(lexical environment),这意味着在函数中定义的内部函数可以引用该函数的变量,如下例所示:
// squares返回一个匿名函数。
// 该匿名函数每次被调用时都会返回下一个数的平方。
func squares() func() int {
    var x int
    return func() int {
        x++
        return x * x
    }
}
func main() {
    f := squares()
    fmt.Println(f()) // "1"
    fmt.Println(f()) // "4"
    fmt.Println(f()) // "9"
    fmt.Println(f()) // "16"
}
函数squares返回另一个类型为 func() int 的函数。对squares的一次调用会生成一个局部变量x并返回一个匿名函数。每次调用匿名函数时,该函数都会先使x的值加1,再返回x的平方。第二次调用squares时,会生成第二个x变量,并返回一个新的匿名函数。新匿名函数操作的是第二个x变量。
闭包捕获迭代变量问题
当在一个循环内部创建闭包(匿名函数)时,如果闭包引用了循环变量,那么所有闭包实际上引用的是同一个变量的内存地址,而不是该变量在某次迭代中的值。这会导致所有闭包在执行时看到的都是最后一次迭代后的循环变量值。
正确的做法
var rmdirs []func()
for _, d := range tempDirs() {
    dir := d // 创建一个新的局部变量来保存当前迭代的值
    os.MkdirAll(dir, 0755)
    rmdirs = append(rmdirs, func() {
        os.RemoveAll(dir) // 使用新的局部变量
    })
}
在这里,dir := d 创建了一个新的局部变量 dir,它独立于循环变量 d。每次循环迭代都会创建一个新的 dir 变量,并且每个闭包都持有这个新变量的引用,因此每个闭包都能正确地引用到各自的目录路径。
错误的做法
var rmdirs []func()
for _, dir := range tempDirs() {
    os.MkdirAll(dir, 0755)
    rmdirs = append(rmdirs, func() {
        os.RemoveAll(dir) // 所有闭包都引用同一个循环变量
    })
}
在这个例子中,所有的闭包都引用了同一个 dir 循环变量,这意味着它们会在实际执行时使用循环结束时 dir 的最终值,导致所有删除操作都作用于最后一个目录上,这不是预期的行为。
对于基于索引的for循环也是一样:
var rmdirs []func()
dirs := tempDirs()
for i := 0; i < len(dirs); i++ {
    os.MkdirAll(dirs[i], 0755)
    rmdirs = append(rmdirs, func() {
        os.RemoveAll(dirs[i]) // 这里的i是一个共享的循环变量
    })
}
同样,这里的 i 是一个共享的循环变量,所以所有闭包都将尝试移除 dirs 列表中由最终的 i 值所指向的元素。
可变参数
参数数量可变的函数称为可变参数函数。典型的例子就是fmt.Printf和类似函数。Printf首先接收一个必备的参数,之后接收任意个数的后续参数。
在声明可变参数函数时,需要在参数列表的最后一个参数类型之前加上省略符号“...”,这表示该函数会接收任意数量的该类型参数。
sum函数返回任意个int型参数的和。在函数体中,vals被看作是类型为[] int的切片。sum可以接收任意数量的int型参数:
在上面的代码中,调用者隐式的创建一个数组,并将原始参数复制到数组中,再把数组的一个切片作为参数传给被调用函数。
如果原始参数已经是切片类型,我们该如何传递给sum?只需在最后一个参数后加上省略符。下面的代码功能与上个例子中最后一条语句相同。
虽然在可变参数函数内部,...int 型参数的行为看起来很像切片类型,但实际上,可变参数函数和以切片作为参数的函数是不同的。
func f(...int) {}
func g([]int) {}
fmt.Printf("%T\n", f) // "func(...int)"
fmt.Printf("%T\n", g) // "func([]int)"
可变参数函数经常被用于格式化字符串。下面的errorf函数构造了一个以行号开头的,经过格式化的错误信息。函数名的后缀f是一种通用的命名规范,代表该可变参数函数可以接收Printf风格的格式化字符串。
func errorf(linenum int, format string, args ...interface{}) {
    fmt.Fprintf(os.Stderr, "Line %d: ", linenum)
    fmt.Fprintf(os.Stderr, format, args...)
    fmt.Fprintln(os.Stderr)
}
linenum, name := 12, "count"
errorf(linenum, "undefined: %s", name) // "Line 12: undefined: count"
interface{}表示函数的最后一个参数可以接收任意类型
defer
直到包含该defer语句的函数执行完毕时,defer后的函数才会被执行,不论包含defer语句的函数是通过return正常结束,还是由于panic导致的异常结束。
defer 语句的执行顺序
-
后进先出(LIFO):当你在一个函数中多次使用
defer时,这些语句会按照后进先出的顺序执行,即最后声明的defer语句会最先执行。 -
在函数返回前执行:
defer语句会在包含它的函数返回之前执行,但是它会在所有代码执行完毕、包括任何return语句之后立即执行。这意味着defer语句会在return语句执行但尚未退出函数时调用。如果return语句有返回值,那么这些返回值会在defer语句执行之前被确定下来。 -
返回值可修改:从Go 1.8开始,如果你有一个
defer的函数调用,并且该函数调用修改了返回值(通过参数引用),那么这些修改会影响最终的返回值。这允许你在defer语句中修改函数的返回值。 -
在Go的panic机制中,延迟函数的调用在释放堆栈信息之前。
以下示例展示了defer语句和return语句之间的交互:
func example() (result int) {
    defer func() {
        result++
        fmt.Println("Deferred function executed")
    }()

    return 42 // 返回值是在deferred函数执行之前确定的
}

func main() {
    fmt.Println(example()) // 输出: Deferred function executed\n43
}
在这个例子中,尽管return语句指定了返回值为42,但在函数返回之前,defer语句中的匿名函数被执行,将返回值result增加了1,因此最终输出的是43。
关于return语句和defer语句
- 当
return语句被执行时,它首先计算并记住了要返回的值。 - 然后,所有已经
defer的函数按后进先出顺序依次执行。 - 最后,函数返回,带着可能已经被
defer语句修改过的返回值。
所以,虽然看起来defer语句是在return之后执行,但实际上它们是紧密相关的:defer语句在return语句确定返回值之后、但在函数真正退出之前执行。
panic
当panic异常发生时,程序会中断运行,并立即执行在该goroutine中被延迟的函数(defer 机制)。随后,程序崩溃并输出日志信息。日志信息包括panic value和函数调用的堆栈跟踪信息。panic value通常是某种错误信息。对于每个goroutine,日志信息中都会有与之相对的,发生panic时的函数调用堆栈跟踪信息。通常,我们不需要再次运行程序去定位问题,日志信息已经提供了足够的诊断依据。因此,在我们填写问题报告时,一般会将panic异常和日志信息一并记录。
其他详见:
https://golang-china.github.io/gopl-zh/ch5/ch5-09.html#:~:text=5.9.-,Panic%E5%BC%82%E5%B8%B8,-Go%E7%9A%84%E7%B1%BB%E5%9E%8B
recover
如果在deferred函数中调用了内置函数recover,并且定义该defer语句的函数发生了panic异常,recover会使程序从panic中恢复,并返回panic value。导致panic异常的函数不会继续运行,但能正常返回。在未发生panic时调用recover,recover会返回nil。
其他详见
https://golang-china.github.io/gopl-zh/ch5/ch5-10.html#:~:text=wa%2Dlang/wabook-,5.10.%20Recover%E6%8D%95%E8%8E%B7%E5%BC%82%E5%B8%B8,-%E9%80%9A%E5%B8%B8%E6%9D%A5%E8%AF%B4%EF%BC%8C%E4%B8%8D
方法
方法声明
和其他面向对象的语言不同,Go接收器不是self或this,而是自定义(当然,我们通常会取第一个字母)
并且Go能够给「任意自定义」类型定义方法,只要这个类型的底层类型不是指针或者interface。
任意自定义类型指的是:底层类型可以是任意类型,但是需要自定义一个命名类型(使用type)
【例1:给int类型定义方法】
这种定义是错的
正确定义:
方法调用
要么接收器的实际参数和其形式参数是相同的类型,比如两者都是类型T或者都是类型*T:
或者接收器实参是类型T,但接收器形参是类型*T,这种情况下编译器会隐式地为我们取变量的地址:
或者接收器实参是类型*T,形参是类型T。编译器会隐式地为我们解引用,取到指针指向的实际变量:
需要注意:
- 不管你的method的receiver是指针类型还是非指针类型,都是可以通过指针/非指针类型进行调用的,编译器会帮你做类型转换。
- 在声明一个method的receiver该是指针还是非指针类型时,你需要考虑两方面的因素,第一方面是这个对象本身是不是特别大,如果声明为非指针变量时,调用会产生一次拷贝;第二方面是如果你用指针类型作为receiver,那么你一定要注意,这种指针类型指向的始终是一块内存地址,就算你对其进行了拷贝(也就是说,拷贝了内存地址,仍然能修改对应地址的值)
- 接收器可以传nil值作为实参
通过嵌入结构体来扩展类型
import "image/color"

type Point struct{ X, Y float64 }

type ColoredPoint struct {
    Point
    Color color.RGBA
}
在以上嵌入结构体中,内嵌可以使我们在定义ColoredPoint时得到一种句法上的简写形式,并使其包含Point类型所具有的一切字段,然后再定义一些自己的。
然而,不仅可以包含Point类型的所有字段,还可以包含Point类型所有方法
Point类型拥有以下方法
func (p Point) Distance(q Point) float64 {
    return math.Hypot(q.X-p.X, q.Y-p.Y)
}

func (p *Point) ScaleBy(factor float64) {
    p.X *= factor
    p.Y *= factor
}
内嵌字段会指导编译器去生成额外的包装方法来委托已经声明好的方法,和下面的形式是等价的:
func (p ColoredPoint) Distance(q Point) float64 {
    return p.Point.Distance(q)
}

func (p *ColoredPoint) ScaleBy(factor float64) {
    p.Point.ScaleBy(factor)
}
也就是说,内嵌会根据被嵌入结构体(Point)包装一个新的函数,在这个函数里面:
- 接收器类型改为嵌入结构体(ColoredPoint)的类型
- 函数内部调用被嵌入结构体(Point)的方法
p.Point.Distance(q) - 函数签名其余部分不变
在类型中内嵌的匿名字段也可能是一个命名类型的指针,这种情况下字段和方法会被间接地引入到当前的类型中(译注:访问需要通过该指针指向的对象去取)。添加这一层间接关系让我们可以共享通用的结构并动态地改变对象之间的关系。下面这个ColoredPoint的声明内嵌了一个*Point的指针。
type ColoredPoint struct {
    *Point
    Color color.RGBA
}

p := ColoredPoint{&Point{1, 1}, red}
q := ColoredPoint{&Point{5, 4}, blue}
fmt.Println(p.Distance(*q.Point)) // "5"
q.Point = p.Point                 // p and q now share the same Point
p.ScaleBy(2)
fmt.Println(*p.Point, *q.Point) // "{2 2} {2 2}"
我们曾经提到,方法只能在命名类型(像Point)或者指向类型的指针上定义,但是多亏了内嵌,有些时候我们给匿名struct类型来定义方法也有了手段。
下面是一个小trick。这个例子展示了简单的cache,其使用两个包级别的变量来实现,一个mutex互斥锁(§9.2)和它所操作的cache:
var (
    mu sync.Mutex // guards mapping
    mapping = make(map[string]string)
)

func Lookup(key string) string {
    mu.Lock()
    v := mapping[key]
    mu.Unlock()
    return v
}
下面这个版本在功能上是一致的,但将两个包级别的变量放在了cache这个struct一组内:
var cache = struct {
    sync.Mutex
    mapping map[string]string
}{
    mapping: make(map[string]string),
}


func Lookup(key string) string {
    cache.Lock()
    v := cache.mapping[key]
    cache.Unlock()
    return v
}
我们给新的变量起了一个更具表达性的名字:cache。因为sync.Mutex字段也被嵌入到了这个struct里,其Lock和Unlock方法也就都被引入到了这个匿名结构中了,这让我们能够以一个简单明了的语法来对其进行加锁解锁操作。
方法值和方法表达式
方法值和函数值意思一样,原先调用方式为p.Distance(q),可以分为两步:
- 取方法值
p.Distance给另一个变量f - 再填入参数q,如
f(q)
方法表达式:在方法值基础上,不写接收器,以接收器的类型取代具体的接收器,在函数多加一个参数,默认第一个参数为接收器
【例1:方法值和方法表达式使用】
package main

import "fmt"

type Point struct {
    x, y int
}

func (p *Point) Distance(q *Point) int {
    return (p.x-q.x)*(p.x-q.x) + (p.y-q.y)*(p.y-q.y)
}

func (p *Point) IncreBy(incre int) {
    p.x++
    p.y++
}

func main() {
    p1 := Point{1, 2}
    p2 := Point{2, 4}

    // 方法值
    distanceFunc1 := p1.Distance
    fmt.Println(distanceFunc1(&p2))

    // 方法表达式
    distanceFunc2 := (*Point).Distance
    fmt.Println(distanceFunc2(&p1, &p2))
}
【例2:方法表达式应用】
当你根据一个变量来决定调用同一个类型的哪个函数时,方法表达式就显得很有用了。你可以根据选择来调用接收器各不相同的方法。下面的例子,变量op代表Point类型的addition或者subtraction方法,Path.TranslateBy方法会为其Path数组中的每一个Point来调用对应的方法:
type Point struct{ X, Y float64 }

func (p Point) Add(q Point) Point { return Point{p.X + q.X, p.Y + q.Y} }
func (p Point) Sub(q Point) Point { return Point{p.X - q.X, p.Y - q.Y} }

type Path []Point

func (path Path) TranslateBy(offset Point, add bool) {
    var op func(p, q Point) Point
    if add {
        op = Point.Add
    } else {
        op = Point.Sub
    }
    for i := range path {
        // Call either path[i].Add(offset) or path[i].Sub(offset).
        path[i] = op(path[i], offset)
    }
}
接口
接口表示一系列行为的集合
接口内嵌
和嵌入结构体一样,以下几种写法同一个意思
写法一
写法二
写法三:甚至使用一种混合的风格:
实现接口的条件
一个类型如果拥有一个接口需要的所有方法,那么这个类型就实现了这个接口。
某类型a实现一个接口类型A,那么a可以用A来表示。
var w io.Writer
w = os.Stdout           // OK: *os.File has Write method
w = new(bytes.Buffer)   // OK: *bytes.Buffer has Write method
w = time.Second         // compile error: time.Duration lacks Write method

var rwc io.ReadWriteCloser
rwc = os.Stdout         // OK: *os.File has Read, Write, Close methods
rwc = new(bytes.Buffer) // compile error: *bytes.Buffer lacks Close method
这个规则甚至适用于等式右边本身也是一个接口类型
w = rwc                 // OK: io.ReadWriteCloser has Write method
rwc = w                 // compile error: io.Writer lacks Close method
特别在函数中,接口类型可以作为函数参数,表示任何实现该接口的类型都可以传入函数
Interface{}表示空接口,任何参数都可以实现空接口,因此interface{}可以表示任何类型的值
尽管Go拥有一个语法糖:无论接收器是类型T还是类型T的指针,调用时(&p).DIstance()和p.Distance()都可以,编译器进行了默认的取地址
func (p *Point) Distance(){ ....}
然而实际上,接收器不同对应不同的方法,因此对应的接口会区分接收器不同的方法
例如:
IntSet类型的String方法的接收者是一个指针类型,所以我们不能在一个不能寻址的IntSet值上调用这个方法:
type IntSet struct { /* ... */ }
func (*IntSet) String() string
var _ = IntSet{}.String() // compile error: String requires *IntSet receiver
但是我们可以在一个IntSet变量上调用这个方法:
然而,由于只有*IntSet类型有String方法,所以也只有*IntSet类型实现了fmt.Stringer接口:
与Java不同,Go实现接口不需要显性定义,因此可以在不修改具体类型的前提下,提取出新的共性作为新接口,例如:
type Audio interface {
    Stream() (io.ReadCloser, error)
    RunningTime() time.Duration
    Format() string // e.g., "MP3", "WAV"
}
type Video interface {
    Stream() (io.ReadCloser, error)
    RunningTime() time.Duration
    Format() string // e.g., "MP4", "WMV"
    Resolution() (x, y int)
}
如果我们发现我们需要以同样的方式处理Audio和Video,我们可以定义一个Streamer接口来代表它们之间相同的部分而不必对已经存在的类型做改变。
type Streamer interface {
    Stream() (io.ReadCloser, error)
    RunningTime() time.Duration
    Format() string
}
接口值
这一节有点像讲接口的原理
接口值有两部分组成:
- 具体类型,称为接口的动态类型
- 具体类型的值,称为接口的动态值
由于Go是静态语言,因此类型是编译期能够确定的
但接口值无法在编译期确定,它是运行时确定的
举例说明
下面4个语句中,变量w得到了3个不同的值。(开始和最后的值是相同的)
第一个语句定义了变量w:
在Go语言中,变量总是被一个定义明确的值初始化,即使接口类型也不例外。对于一个接口的零值就是它的类型和值的部分都是nil(图7.1)。
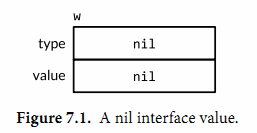
一个接口值基于它的动态类型被描述为空或非空,所以这是一个空的接口值。你可以通过使用w==nil或者w!=nil来判断接口值是否为空。调用一个空接口值上的任意方法都会产生panic:
第二个语句将一个*os.File类型的值赋给变量w:
这个赋值过程调用了一个具体类型到接口类型的隐式转换,这和显式的使用io.Writer(os.Stdout)是等价的。
这个接口值的动态类型为*os.File,它的动态值为os.Stdout的拷贝
os.Stdout是一个变量,类型为*os.FIle。
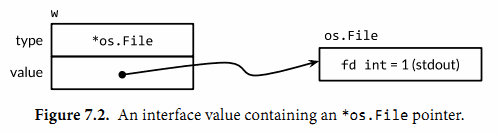
调用一个包含*os.File类型指针的接口值的Write方法,使得(*os.File).Write方法被调用。这个调用输出“hello”。
接口值的调用方法使用了动态分配(dynamic dispatch):
- 找到动态类型对应的方法
(*os.File).Write - 将动态值的拷贝作为该方法的接收器
效果和下面这个直接调用一样:
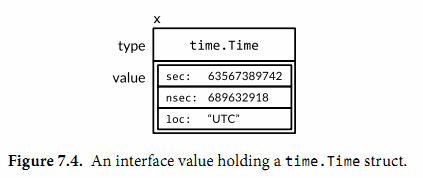
一个接口值可以持有任意大的动态值。例如,表示时间实例的time.Time类型,这个类型有几个对外不公开的字段。我们从它上面创建一个接口值:
结果可能和图7.4相似。从概念上讲,不论接口值多大,动态值总是可以容下它。(这只是一个概念上的模型;具体的实现可能会非常不同)
接口使用注意事项
接口值的比较
接口值可以使用==和!=来进行比较。两个接口值相等仅当:
- 它们都是nil值
- 或者它们的动态类型相同,并且动态类型属于可比较的类型,并且动态值相等。
因为接口值是可比较的,所以它们可以用在map的键或者作为switch语句的操作数。
但是如果两个接口值的动态类型相同,但是这个动态类型是不可比较的(比如切片),将它们进行比较就会失败并且panic:
考虑到这点,接口类型是非常与众不同的。其它类型要么是安全的可比较类型(如基本类型和指针)要么是完全不可比较的类型(如切片,映射类型,和函数),但是在比较接口值或者包含了接口值的聚合类型时,我们必须要意识到潜在的panic。同样的风险也存在于使用接口作为map的键或者switch的操作数。只能比较你非常确定它们的动态值是可比较类型的接口值。
当我们处理错误或者调试的过程中,得知接口值的动态类型是非常有帮助的。所以我们使用fmt包的%T动作:
var w io.Writer
fmt.Printf("%T\n", w) // "<nil>"
w = os.Stdout
fmt.Printf("%T\n", w) // "*os.File"
w = new(bytes.Buffer)
fmt.Printf("%T\n", w) // "*bytes.Buffer"
一个包含nil指针的接口不是nil接口
一个不包含任何值的nil接口值和一个刚好包含nil指针的接口值是不同的。
思考下面的程序。当debug变量设置为true时,main函数会将f函数的输出收集到一个bytes.Buffer类型中。
const debug = true

func main() {
    var buf *bytes.Buffer
    if debug {
        buf = new(bytes.Buffer) // enable collection of output
    }
    f(buf) // NOTE: subtly incorrect!
    if debug {
        // ...use buf...
    }
}

// If out is non-nil, output will be written to it.
func f(out io.Writer) {
    // ...do something...
    if out != nil {
        out.Write([]byte("done!\n"))
    }
}
我们可能会预计当把变量debug设置为false时可以禁止对输出的收集,但是实际上在out.Write方法调用时程序发生了panic:
当main函数调用函数f时,它给f函数的out参数赋了一个*bytes.Buffer的空指针,所以out的动态值是nil。然而,它的动态类型是*bytes.Buffer,意思就是out变量是一个包含空指针值的非空接口(如图7.5),所以防御性检查out!=nil的结果依然是true。

动态分配机制依然决定(*bytes.Buffer).Write的方法会被调用,但是这次的接收者的值是nil。对于一些如*os.File的类型,nil是一个有效的接收者(§6.2.1)。
但问题在于尽管一个nil的*bytes.Buffer指针有实现这个接口的方法,但(*bytes.Buffer).Write方法的接收者不能为空,所以将nil指针赋给这个接口是错误的,会引发panic
解决方案就是将main函数中的变量buf的类型改为io.Writer,因此可以避免一开始就将一个不完整的值赋值给这个接口:
特殊接口类型
sort.Interface
sort包提供自定义类型排序方法的接口sort.Interface,只要实现这个接口,就可以使用sort.Sort进行自定义排序
sort.Interface定义如下:
package sort

type Interface interface {
    Len() int
    Less(i, j int) bool // i, j are indices of sequence elements
    Swap(i, j int)
}
举个例子
type Track struct {
    Title  string
    Artist string
    Album  string
    Year   int
    Length time.Duration
}

type byArtist []*Track
func (x byArtist) Len() int           { return len(x) }
func (x byArtist) Less(i, j int) bool { return x[i].Artist < x[j].Artist }
func (x byArtist) Swap(i, j int)      { x[i], x[j] = x[j], x[i] }

sort.Sort(byArtist(tracks))
如果想要反向排序,不需要重新实现接口
sort.Reverse 接受一个实现了 sort.Interface 的接口作为参数,并返回一个新的 sort.Interface 实现,这个新的实现会将原接口中的 Less 方法的行为反转,从而改变排序的方向。
sort包定义了一个不公开的struct类型reverse,它嵌入了一个sort.Interface。reverse的Less方法调用了内嵌的sort.Interface值的Less方法,但是通过交换索引的方式使排序结果变成逆序。
package sort

type reverse struct{ Interface } // that is, sort.Interface

func (r reverse) Less(i, j int) bool { return r.Interface.Less(j, i) }

func Reverse(data Interface) Interface { return reverse{data} }
reverse的另外两个方法Len和Swap隐式地由原有内嵌的sort.Interface提供。因为reverse是一个不公开的类型,所以导出函数Reverse返回一个包含原有sort.Interface值的reverse类型实例。
http.Handler
error
error其实是一个接口,定义如下:
创建一个error最简单的方法就是调用errors.New函数,它会根据传入的错误信息返回一个新的error。整个errors包仅只有4行:
package errors

func New(text string) error { return &errorString{text} }

type errorString struct { text string }

func (e *errorString) Error() string { return e.text }
承载errorString的类型是一个结构体而非一个字符串,这是为了保护它表示的错误避免粗心(或有意)的更新。并且因为是指针类型*errorString满足error接口而非errorString类型,所以每个New函数的调用都分配了一个独特的和其他错误不相同的实例。
如下例,errors.New 函数返回的是一个实现了 error 接口的新对象。每个对象都有自己独立的内存地址,即使它们的内容相同,这两个对象也不会被认为是相等的,因为它们不是同一个实例。
我们也不想要重要的error例如io.EOF和一个刚好有相同错误消息的error比较后相等。
调用errors.New函数是非常稀少的,因为有一个方便的封装函数fmt.Errorf,它还会处理字符串格式化。
package fmt

import "errors"

func Errorf(format string, args ...interface{}) error {
    return errors.New(Sprintf(format, args...))
}
Goroutines和Channel
Goroutines
当一个程序启动时,其主函数即在一个单独的goroutine中运行,我们叫它main goroutine。新的goroutine会用go语句来创建。
主函数返回时,所有的goroutine都会被直接打断,程序退出。
除了从主函数退出或者直接终止程序之外,没有其它的编程方法能够让一个goroutine来打断另一个的执行,但是之后可以看到一种方式来实现这个目的,通过goroutine之间的通信来让一个goroutine请求其它的goroutine,并让被请求的goroutine自行结束执行。
【例1:Goroutines的应用】
我觉得这个例子很有趣哈哈哈所以放上来了
func main() {
    go spinner(100 * time.Millisecond)
    const n = 45
    fibN := fib(n) // slow
    fmt.Printf("\rFibonacci(%d) = %d\n", n, fibN)
}

func spinner(delay time.Duration) {
    for {
        for _, r := range `-\|/` {
            fmt.Printf("\r%c", r)
            time.Sleep(delay)
        }
    }
}

func fib(x int) int {
    if x < 2 {
        return x
    }
    return fib(x-1) + fib(x-2)
}
回车符
\r的作用回车符:将光标移回到当前行的开头,但不会移动到下一行。这意味着任何后续的输出都会覆盖当前行的内容,直到遇到换行符
\n或到达现有文本的末尾。使用场景
- 更新同一行的内容:当你想在同一行上更新信息而不滚动屏幕时,可以使用
\r。这在显示进度条或实时更新状态信息时非常有用。- 模拟覆盖效果:如果你想要覆盖之前打印的内容,可以先打印一段文本,然后使用
\r返回行首并打印新的内容。
Channel
一个channel是一个通信机制,它可以让一个goroutine通过它给另一个goroutine发送值信息。
每个channel都有一个特殊的类型,也就是channels可发送数据的类型。一个可以发送int类型数据的channel一般写为chan int。
使用内置的make函数,我们可以创建一个channel:
以最简单方式调用make函数创建的是一个无缓存的channel,但是我们也可以指定第二个整型参数,对应channel的容量。如果channel的容量大于零,那么该channel就是带缓存的channel。
ch = make(chan int)    // unbuffered channel
ch = make(chan int, 0) // unbuffered channel
ch = make(chan int, 3) // buffered channel with capacity 3
和map类似,channel也对应一个make创建的底层数据结构的引用。当我们复制一个channel或用于函数参数传递时,我们只是拷贝了一个channel引用,因此调用者和被调用者将引用同一个channel对象。和其它的引用类型一样,channel的零值也是nil。
两个相同类型的channel可以使用==运算符比较。如果两个channel引用的是相同的对象,那么比较的结果为真。一个channel也可以和nil进行比较。
channel的发送和接收操作
ch <- x  // a send statement
x = <-ch // a receive expression in an assignment statement
<-ch     // a receive statement; result is discarded
channel还支持close操作,用于关闭channel
channel关闭后不能发送,但是可以接收
- 关闭channel后,对基于该channel的任何发送操作都将导致panic异常。
- 对一个已经被close过的channel进行接收操作依然可以接受到之前已经成功发送的数据;如果channel中已经没有数据的话将产生一个零值的数据。
使用内置的close函数就可以关闭一个channel:
不带缓存的channel
基于无缓存Channels的发送和接收操作将导致两个goroutine做一次同步操作。因为这个原因,无缓存Channels有时候也被称为同步Channels。
一个基于无缓存Channels的发送操作将导致发送者goroutine阻塞,直到另一个goroutine在相同的Channels上执行接收操作,当发送的值通过Channels成功传输之后,两个goroutine可以继续执行后面的语句。反之,如果接收操作先发生,那么接收者goroutine也将阻塞,直到有另一个goroutine在相同的Channels上执行发送操作。
【例子】
我们需要让主goroutine等待后台goroutine完成工作后再退出,我们使用了一个channel来同步两个goroutine:
func main() {
    conn, err := net.Dial("tcp", "localhost:8000")
    if err != nil {
        log.Fatal(err)
    }
    done := make(chan struct{})
    go func() {
        io.Copy(os.Stdout, conn) // NOTE: ignoring errors
        log.Println("done")
        done <- struct{}{} // signal the main goroutine
    }()
    mustCopy(conn, os.Stdin)
    conn.Close()
    <-done // wait for background goroutine to finish
}
串联的channel
详见https://golang-china.github.io/gopl-zh/ch8/ch8-04.html#:~:text=%E4%B8%B2%E8%81%94%E7%9A%84Channels%EF%BC%88Pipeline%EF%BC%89
channel可以作为两个goroutine之间传输数据的管道
【例子】
对于发送者,如果没有数据需要发送,可以直接
一个channel被关闭后,再向该channel发送数据将导致panic异常。
对于接收者,发送者关闭channel并且channel的数据都被接收者处理完后,接收者不会被阻塞,而是立即返回零值(即接收者在这种情况下无法知道发送者是否关闭channel)
接收操作有一个变体形式:它多接收一个结果,多接收的第二个结果是一个布尔值ok,ture表示成功从channels接收到值,false表示channels已经被关闭并且里面没有值可接收。使用这个特性,我们可以修改squarer函数中的循环代码,当naturals对应的channel被关闭并没有值可接收时跳出循环,并且也关闭squares对应的channel.
// Squarer
go func() {
    for {
        x, ok := <-naturals
        if !ok {
            break // channel was closed and drained
        }
        squares <- x * x
    }
    close(squares)
}()
range对以上方法进行了简化,等价于以下形式
对于channel, for range结束的条件是:channel被close
func main() {
    naturals := make(chan int)
    squares := make(chan int)

    // Counter
    go func() {
        for x := 0; x < 100; x++ {
            naturals <- x
        }
        close(naturals)
    }()

    // Squarer
    go func() {
        for x := range naturals {
            squares <- x * x
        }
        close(squares)
    }()

    // Printer (in main goroutine)
    for x := range squares {
        fmt.Println(x)
    }
}
其实你并不需要关闭每一个channel(只需要关闭发送者channel)。只有当需要告诉接收者goroutine,所有的数据已经全部发送时才需要关闭channel。不管一个channel是否被关闭,当它没有被引用时将会被Go语言的垃圾自动回收器回收。(不要将关闭一个打开文件的操作和关闭一个channel操作混淆。对于每个打开的文件,都需要在不使用的时候调用对应的Close方法来关闭文件。)
试图重复关闭一个channel将导致panic异常,试图关闭一个nil值的channel也将导致panic异常。
单方向的channel
- 类型
chan<- int表示一个只发送int的channel,只能发送不能接收。 - 类型
<-chan int表示一个只接收int的channel,只能接收不能发送。
(箭头<-和关键字chan的相对位置表明了channel的方向。)这种限制将在编译期检测。
【例子:在「串联的channel」章节最后出现的代码进行优化】
unc counter(out chan<- int) {
    for x := 0; x < 100; x++ {
        out <- x
    }
    close(out)
}

func squarer(out chan<- int, in <-chan int) {
    for v := range in {
        out <- v * v
    }
    close(out)
}

func printer(in <-chan int) {
    for v := range in {
        fmt.Println(v)
    }
}

func main() {
    naturals := make(chan int)
    squares := make(chan int)
    go counter(naturals)
    go squarer(squares, naturals)
    printer(squares)
}
调用counter(naturals)时,naturals的类型将隐式地从chan int转换成chan<- int。调用printer(squares)也会导致相似的隐式转换,这一次是转换为<-chan int类型只接收型的channel。任何双向channel向单向channel变量的赋值操作都将导致该隐式转换。这里并没有反向转换的语法:也就是不能将一个类似chan<- int类型的单向型的channel转换为chan int类型的双向型的channel。
带缓存的channel
带缓存的Channel内部持有一个元素队列。队列的最大容量是在调用make函数创建channel时通过第二个参数指定的。下面的语句创建了一个可以持有三个字符串元素的带缓存Channel。图8.2是ch变量对应的channel的图形表示形式。

向缓存Channel的发送操作就是向内部缓存队列的尾部插入元素,接收操作则是从队列的头部删除元素。
如果内部缓存队列是满的,那么发送操作将阻塞直到因另一个goroutine执行接收操作而释放了新的队列空间。相反,如果channel是空的,接收操作将阻塞直到有另一个goroutine执行发送操作而向队列插入元素。
在某些特殊情况下,程序可能需要知道channel内部缓存的容量,可以用内置的cap函数获取:
同样,对于内置的len函数,如果传入的是channel,那么将返回channel内部缓存队列中有效元素的个数。
goroutine泄漏
func mirroredQuery() string {
    responses := make(chan string, 3)
    go func() { responses <- request("asia.gopl.io") }()
    go func() { responses <- request("europe.gopl.io") }()
    go func() { responses <- request("americas.gopl.io") }()
    return <-responses // return the quickest response
}

func request(hostname string) (response string) { /* ... */ }
如果我们使用了无缓存的channel,那么两个慢的goroutines将会因为没有人接收而被永远卡住。这种情况,称为goroutines泄漏,这将是一个BUG。和垃圾变量不同,泄漏的goroutines并不会被自动回收,因此确保每个不再需要的goroutine能正常退出是重要的。
缓存Channel和无缓存Channel的选择
- 无缓存channel更强地保证了每个发送操作与相应的同步接收操作;
- 对于带缓存channel,这些操作是解耦的。即使我们知道将要发送到一个channel的信息的数量上限,创建一个对应容量大小的带缓存channel也是不现实的,因为这要求在执行任何接收操作之前缓存所有已经发送的值。如果未能分配足够的缓存将导致程序死锁:发送者会在尝试发送新消息时阻塞,而接收者可能还未准备好接收,最终可能导致程序陷入死锁状态。
两者的选择还会牵扯到生产者和消费者的关系,根据生产速度和消费速度调整缓存大小
使用场景
主goroutine等待其他goroutine完成再结束
使用无缓存channel,发送struct{}
错误写法
for range [channel]用于channel已关闭的时候,如果channel没有关闭,则会一直阻塞,等待channel上有新的数据到达。它会持续监听channel,直到channel被关闭
func makeThumbnails3(filenames []string) {
    ch := make(chan struct{})
    for _, f := range filenames {
        go func(f string) {
            thumbnail.ImageFile(f) // NOTE: ignoring errors
            ch <- struct{}{}
        }(f)
    }
    // 这里写的不对!
    for range ch {
    }
}
正确写法
// makeThumbnails3 makes thumbnails of the specified files in parallel.
func makeThumbnails3(filenames []string) {
    ch := make(chan struct{})
    for _, f := range filenames {
        go func(f string) {
            thumbnail.ImageFile(f) // NOTE: ignoring errors
            ch <- struct{}{}
        }(f)
    }
    // Wait for goroutines to complete.
    for range filenames {
        <-ch
    }
}
已知迭代次数,worker goroutine往主goroutine中返回值
错误写法
// makeThumbnails4 makes thumbnails for the specified files in parallel.
// It returns an error if any step failed.
func makeThumbnails4(filenames []string) error {
    errors := make(chan error)

    for _, f := range filenames {
        go func(f string) {
            _, err := thumbnail.ImageFile(f)
            errors <- err
        }(f)
    }

    for range filenames {
        if err := <-errors; err != nil {
            return err // NOTE: incorrect: goroutine leak!
        }
    }

    return nil
}
这个程序有一个微妙的bug。当它遇到第一个非nil的error时会直接将error返回到调用方,使得没有一个goroutine去排空errors channel。这样剩下的worker goroutine在向这个channel中发送值时,都会永远地阻塞下去,并且永远都不会退出。这种情况叫做goroutine泄露,可能会导致整个程序卡住或者跑出out of memory的错误。
解决办法
最简单的解决办法就是用一个具有合适大小的buffered channel,这样这些worker goroutine向channel中发送错误时就不会被阻塞。(一个可选的解决办法是创建一个另外的goroutine,当main goroutine返回第一个错误的同时去排空channel。)
正确写法
// makeThumbnails5 makes thumbnails for the specified files in parallel.
// It returns the generated file names in an arbitrary order,
// or an error if any step failed.
func makeThumbnails5(filenames []string) (thumbfiles []string, err error) {
    type item struct {
        thumbfile string
        err       error
    }

    ch := make(chan item, len(filenames))
    for _, f := range filenames {
        go func(f string) {
            var it item
            it.thumbfile, it.err = thumbnail.ImageFile(f)
            ch <- it
        }(f)
    }

    for range filenames {
        it := <-ch
        if it.err != nil {
            return nil, it.err
        }
        thumbfiles = append(thumbfiles, it.thumbfile)
    }

    return thumbfiles, nil
}
不知道迭代次数,统计每个goroutine的返回值
为了知道最后一个goroutine什么时候结束(最后一个结束并不一定是最后一个开始),我们需要一个递增的计数器,在每一个goroutine启动时加一,在goroutine退出时减一。这需要一种特殊的计数器,这个计数器需要在多个goroutine操作时做到安全并且提供在其减为零之前一直等待的一种方法。这种计数类型被称为sync.WaitGroup,下面的代码就用到了这种方法:
// makeThumbnails6 makes thumbnails for each file received from the channel.
// It returns the number of bytes occupied by the files it creates.
func makeThumbnails6(filenames <-chan string) int64 {
    sizes := make(chan int64)
    var wg sync.WaitGroup // number of working goroutines
    for f := range filenames {
        wg.Add(1)
        // worker
        go func(f string) {
            defer wg.Done()
            thumb, err := thumbnail.ImageFile(f)
            if err != nil {
                log.Println(err)
                return
            }
            info, _ := os.Stat(thumb) // OK to ignore error
            sizes <- info.Size()
        }(f)
    }

    // closer
    go func() {
        wg.Wait()
        close(sizes)
    }()

    var total int64
    for size := range sizes {
        total += size
    }
    return total
}
注意Add和Done方法的不对称。Add是为计数器加一,必须在worker goroutine开始之前调用,而不是在goroutine中;否则的话我们没办法确定Add是在"closer" goroutine调用Wait之前被调用。并且Add还有一个参数,但Done却没有任何参数;其实它和Add(-1)是等价的。我们使用defer来确保计数器即使是在出错的情况下依然能够正确地被减掉。上面的程序代码结构是当我们使用并发循环,但又不知道迭代次数时很通常而且很地道的写法。
sizes channel携带了每一个文件的大小到main goroutine,在main goroutine中使用了range loop来计算总和。观察一下我们是怎样创建一个closer goroutine,并让其在所有worker goroutine们结束之后再关闭sizes channel的。两步操作:wait和close,必须是基于sizes的循环的并发。考虑一下另一种方案:如果等待操作被放在了main goroutine中,在循环之前,这样的话就永远都不会结束了,如果在循环之后,那么又变成了不可达的部分,因为没有任何东西去关闭这个channel,这个循环就永远都不会终止。
控制并发量
对links.Extract的调用操作用获取、释放token的操作包裹起来,来确保同一时间对其只有20个调用。信号量数量和其能操作的IO资源数量应保持接近。
// tokens is a counting semaphore used to
// enforce a limit of 20 concurrent requests.
var tokens = make(chan struct{}, 20)

func crawl(url string) []string {
    fmt.Println(url)
    tokens <- struct{}{} // acquire a token
    list, err := links.Extract(url)
    <-tokens // release the token
    if err != nil {
        log.Print(err)
    }
    return list
}
基于共享变量的并发
当我们没有办法自信地确认一个事件是在另一个事件的前面或者后面发生的话,就说明x和y这两个事件是并发的。
考虑一下,一个函数在线性程序中可以正确地工作。如果在并发的情况下,这个函数依然可以正确地工作的话,那么我们就说这个函数是并发安全的,并发安全的函数不需要额外的同步工作。
共享变量安全并发的三种情况
- 多个goroutine不写共享变量,只读共享变量
- 绑定:只有一个goroutine能访问变量,其它的goroutine不能够直接访问变量,它们只能使用一个channel来发送请求给指定的goroutine来查询更新变量。
- 互斥:允许很多goroutine去访问变量,但是在同一个时刻最多只有一个goroutine在访问。
导出的函数通常是并发安全的
sync.Mutex互斥锁
原始实现互斥锁的方法
var (
    sema    = make(chan struct{}, 1) // a binary semaphore guarding balance
    balance int
)

func Deposit(amount int) {
    sema <- struct{}{} // acquire token
    balance = balance + amount
    <-sema // release token
}

func Balance() int {
    sema <- struct{}{} // acquire token
    b := balance
    <-sema // release token
    return b
}
go支持互斥锁
import "sync"

var (
    mu      sync.Mutex // guards balance
    balance int
)

func Deposit(amount int) {
    mu.Lock()
    balance = balance + amount
    mu.Unlock()
}

func Balance() int {
    mu.Lock()
    defer mu.Unlock()
    return balance
}
Sync.RWMutex读写锁
同理
内存同步
如果是多个goroutine都需要访问的变量,使用互斥条件来访问。
以下x, y都是共享变量,没有互斥,因此会产生数据竞争
var x, y int
go func() {
    x = 1 // A1
    fmt.Print("y:", y, " ") // A2
}()
go func() {
    y = 1                   // B1
    fmt.Print("x:", x, " ") // B2
}()
不仅会出现
还会出现
前四种情况比较好解释,后两种情况需要这样解释:
在多核CPU中,每个CPU拥有自己的cache,因此当CPU完成计算,cache拥有最新的版本,但是内存还没有更新。
需要存在每个CPUcache拷贝数据到内存的过程
而变量x, y是存储在内存而不是在cache中,因此假设goroutine1更新了x = 1,但是还没有写进内存中,goroutine2无法知道x已经被更新,直接打印x = 0;y同理
编译器和CPU是可以随意地去更改访问内存的指令顺序,以任意方式,只要保证每一个goroutine自己的执行顺序一致。
sync.Once
简单来说,sync.Once能够让函数只执行一次
- sync.Once 可以在代码的任意位置初始化和调用,因此可以延迟到使用时再执行,并发场景下是线程安全的。
在多数情况下,sync.Once 被用于控制变量的初始化,这个变量的读写满足如下三个条件:
- 当且仅当第一次访问某个变量时,进行初始化(写);
- 变量初始化过程中,所有读都被阻塞,直到初始化完成;
- 变量仅初始化一次,初始化完成后驻留在内存里
var loadIconsOnce sync.Once
var icons map[string]image.Image
// Concurrency-safe.
func Icon(name string) image.Image {
    loadIconsOnce.Do(loadIcons)
    return icons[name]
}
每一次对Do(loadIcons)的调用都会锁定mutex,并会检查boolean变量(译注:Go1.9中会先判断boolean变量是否为1(true),只有不为1才锁定mutex,不再需要每次都锁定mutex)。在第一次调用时,boolean变量的值是false,Do会调用loadIcons并会将boolean变量设置为true。随后的调用什么都不会做,但是mutex同步会保证loadIcons对内存(这里其实就是指icons变量啦)产生的效果能够对所有goroutine可见。用这种方式来使用sync.Once的话,我们能够避免在变量被构建完成之前和其它goroutine共享该变量。
竞争条件检测
只要在go build,go run或者go test命令后面加上-race的flag,就会使编译器创建一个你的应用的“修改”版或者一个附带了能够记录所有运行期对共享变量访问工具的test,并且会记录下每一个读或者写共享变量的goroutine的身份信息。
竞争检查器会报告所有的已经发生的数据竞争。然而,它只能检测到运行时的竞争条件;并不能证明之后不会发生数据竞争。所以为了使结果尽量正确,请保证你的测试并发地覆盖到了你的包。
Go实现数据类型
栈
一个slice可以用来模拟一个stack。最初给定的空slice对应一个空的stack,然后可以使用append函数将新的值压入stack:
stack的顶部位置对应slice的最后一个元素:
通过收缩stack可以弹出栈顶的元素
要删除slice中间的某个元素并保存原有的元素顺序,可以通过内置的copy函数将后面的子slice向前依次移动一位完成:
func remove(slice []int, i int) []int {
    copy(slice[i:], slice[i+1:])
    return slice[:len(slice)-1]
}

func main() {
    s := []int{5, 6, 7, 8, 9}
    fmt.Println(remove(s, 2)) // "[5 6 8 9]"
}
如果删除元素后不用保持原来顺序的话,我们可以简单的用最后一个元素覆盖被删除的元素:
func remove(slice []int, i int) []int {
    slice[i] = slice[len(slice)-1]
    return slice[:len(slice)-1]
}

func main() {
    s := []int{5, 6, 7, 8, 9}
    fmt.Println(remove(s, 2)) // "[5 6 9 8]
}
集合
Go语言里的集合一般会用map[T]bool这种形式来表示,T代表元素类型。
例如下面的dedup程序读取多行输入,但是只打印第一次出现的行。(它是1.3节中出现的dup程序的变体。)dedup程序通过map来表示所有的输入行所对应的set集合,以确保已经在集合存在的行不会被重复打印。
func main() {
    seen := make(map[string]bool) // a set of strings
    input := bufio.NewScanner(os.Stdin)
    for input.Scan() {
        line := input.Text()
        if !seen[line] {
            seen[line] = true
            fmt.Println(line)
        }
    }

    if err := input.Err(); err != nil {
        fmt.Fprintf(os.Stderr, "dedup: %v\n", err)
        os.Exit(1)
    }
}
Map
原生map即可
Bit数组
https://golang-china.github.io/gopl-zh/ch6/ch6-05.html
Go包管理
包管理是Go非常重要的一环,为此我新开了一个chapter
Reference
基础知识
Go里面的包(package),简单来说,就是Go存放一组.go文件的目录。
所有的.go文件必须在第一行声明所属的包名,同一个目录下的所有.go文件必须声明同一个包名。
Go中的包分为库(Library,简称lib包)和可执行包(main包),区分两者非常简单:
- lib包没有main.go,lib包内所有.go第一行都是
package + lib包名 - main包一定有main.go,main包内所有.go第一行都是
package main
Go编译器编译时,会寻找main包,接着寻找main包中的main.go文件。main.go是程序的入口,如果项目拥有main包且main.go文件,编译器会将main包编译为二进制可执行文件。
包内需要导出的函数和变量使用大写,否则小写
Go module
以前Go使用GOPATH来存放项目,非常麻烦。后面Go1.11推出了Go module包管理(类似于Java的Maven和Rust的cargo)
现在我们基本都使用Go module(通常使用Go mod代称)
Go module基础
创建Go module
go build <filename> 编译go module,如果没有加filename,默认寻找当前目录main.go
go run <filename> 编译并运行某个go module,如果没有加filename,默认寻找当前目录main.go
当前目录:go build . & go run .
Go module导入包
go get与go install的区别
【stack overflow】go get与go install的区别
简单总结
- 如果你需要管理项目的依赖,使用
go get。 - 如果你需要安装工具或可执行文件,使用
go install。
1. go get
go get 主要用于下载和安装远程的 Go 包或模块,并将其添加到当前模块的依赖中。它会更新 go.mod 和 go.sum 文件。
主要功能:
- 下载远程包或模块。
- 将依赖添加到
go.mod文件中。 - 安装包的可执行文件(如果包是
main包)。
常用命令:
- 下载并添加依赖:
- 下载指定版本的依赖:
- 更新依赖到最新版本:
注意事项:
- 从 Go 1.18 开始,
go get不再用于安装可执行文件(这是go install的职责),而是专注于管理依赖。 - 如果下载的包是
main包,go get会将其编译并安装到$GOPATH/bin目录(如果设置了GOBIN环境变量,则安装到GOBIN目录)。
2. go install
go install 用于编译并安装 Go 包或可执行文件。它不会修改 go.mod 或 go.sum 文件。
主要功能:
- 编译并安装指定的包或可执行文件。
- 将生成的可执行文件安装到
$GOPATH/bin或GOBIN目录。
常用命令:
- 安装当前目录下的包:
- 安装指定路径的包:
- 安装指定版本的包(需要 Go 1.16+):
注意事项:
go install不会修改go.mod或go.sum文件,因此它不会影响项目的依赖管理。- 它主要用于安装工具或可执行文件,而不是管理项目依赖。
主要区别
| 特性 | go get | go install |
|---|---|---|
| 功能 | 下载依赖并更新 go.mod 文件 | 编译并安装可执行文件 |
修改 go.mod | 是 | 否 |
| 安装位置 | $GOPATH/bin 或 GOBIN | $GOPATH/bin 或 GOBIN |
| 适用场景 | 管理项目依赖 | 安装工具或可执行文件 |
| 版本管理 | 支持指定版本(@v1.2.3) | 支持指定版本(@v1.2.3) |
| Go 1.16+ 变化 | 不再用于安装可执行文件 | 推荐用于安装可执行文件 |
使用场景示例
1. 使用 go get 管理依赖
假设你需要在项目中添加一个新的依赖:
这会将 gin 添加到 go.mod 文件中,并下载指定版本。
2. 使用 go install 安装工具
假设你需要安装一个常用的 Go 工具,比如 golangci-lint:
这会将 golangci-lint 安装到 $GOPATH/bin 或 GOBIN 目录,而不会影响当前项目的依赖。
创建多个Go module的工作空间
go work init <mod name>
# 创建go.work文件,包含mod name所在go mod

# 如果没有指定mod name,创建空的go.work

go work use <mod name>
# 将指定go mod添加到go.work
Go常用包
fmt
Printf函数
打印变量
%v
打印二进制
下面的代码演示了如何使用位操作解释uint8类型值的8个独立的bit位。它使用了Printf函数的%b参数打印二进制格式的数字;其中%08b中08表示打印至少8个字符宽度,不足的前缀部分用0填充。
var x uint8 = 1<<1 | 1<<5
var y uint8 = 1<<1 | 1<<2

fmt.Printf("%08b\n", x) // "00100010", the set {1, 5}
fmt.Printf("%08b\n", y) // "00000110", the set {1, 2}

fmt.Printf("%08b\n", x&y)  // "00000010", the intersection {1}
fmt.Printf("%08b\n", x|y)  // "00100110", the union {1, 2, 5}
fmt.Printf("%08b\n", x^y)  // "00100100", the symmetric difference {2, 5}
fmt.Printf("%08b\n", x&^y) // "00100000", the difference {5}

for i := uint(0); i < 8; i++ {
    if x&(1<<i) != 0 { // membership test
        fmt.Println(i) // "1", "5"
    }
}

fmt.Printf("%08b\n", x<<1) // "01000100", the set {2, 6}
fmt.Printf("%08b\n", x>>1) // "00010001", the set {0, 4}
打印其他进制
o := 0666
fmt.Printf("%d %[1]o %#[1]o\n", o) // "438 666 0666"
x := int64(0xdeadbeef)
fmt.Printf("%d %[1]x %#[1]x %#[1]X\n", x)
// Output:
// 3735928559 deadbeef 0xdeadbeef 0XDEADBEEF
请注意fmt的两个使用技巧。通常Printf格式化字符串包含多个%参数时将会包含对应相同数量的额外操作数,但是%之后的[1]副词告诉Printf函数再次使用第一个操作数。第二,%后的#副词告诉Printf在用%o、%x或%X输出时生成0、0x或0X前缀。
字符面值通过一对单引号直接包含对应字符。最简单的例子是ASCII中类似'a'写法的字符面值,但是我们也可以通过转义的数值来表示任意的Unicode码点对应的字符,马上将会看到这样的例子。
打印字符
字符使用%c参数打印,或者是用%q参数打印带单引号的字符:
ascii := 'a'
unicode := '国'
newline := '\n'
fmt.Printf("%d %[1]c %[1]q\n", ascii)   // "97 a 'a'"
fmt.Printf("%d %[1]c %[1]q\n", unicode) // "22269 国 '国'"
fmt.Printf("%d %[1]q\n", newline)       // "10 '\n'"
打印浮点数
有三种打印方式,如下图:
package main

import "fmt"

func main(){
    const a = 2e10
    const b = 2e-10
    fmt.Printf("%g %g\n",a,b)
    //output: 2e+10 2e-10

    fmt.Printf("%f %f\n",a,b)
    //output: 20000000000.000000 0.000000

    fmt.Printf("%e %e\n",a,b)
    //output: 2.000000e+10 2.000000e-10

}
用Printf函数的%g参数打印浮点数,将采用更紧凑的表示形式打印,并提供足够的精度,但是对应表格的数据,使用%e(带指数)或%f的形式打印可能更合适。
所有的这三个打印形式都可以指定打印的宽度和控制打印精度。
另一示例
for x := 0; x < 8; x++ {
    fmt.Printf("x = %d e^x = %8.3f\n", x, math.Exp(float64(x)))
}
上面代码打印e的幂,打印精度是小数点后三个小数精度和8个字符宽度:


x = 0       e^x =    1.000
x = 1       e^x =    2.718
x = 2       e^x =    7.389
x = 3       e^x =   20.086
x = 4       e^x =   54.598
x = 5       e^x =  148.413
x = 6       e^x =  403.429
x = 7       e^x = 1096.633
打印布尔值
%t
flag
flag 包用于解析命令行参数,使程序能够接受用户输入的各种选项和参数。
sort
排序函数
sort.Slice(slice, less):对任意类型的切片进行排序,less是一个比较函数,决定元素之间的顺序。sort.Ints(slice):对[]int类型的切片进行升序排序。sort.Strings(slice):对[]string类型的切片进行字典序排序。sort.Float64s(slice):对[]float64类型的切片进行升序排序。sort.Sort(data Interface):对实现了sort.Interface接口的类型进行排序。
检查是否已排序
sort.IsSorted(data Interface):检查数据是否已经按照Less方法指定的顺序排好序。
查找元素
sort.SearchInts(a []int, x int):在一个已经排序的[]int中查找给定值的位置。sort.SearchStrings(a []string, x string):在一个已经排序的[]string中查找给定字符串的位置。sort.SearchFloat64s(a []float64, x float64):在一个已经排序的[]float64中查找给定浮点数的位置。sort.Search(n int, f func(int) bool):在区间[0, n)内执行二分搜索,返回满足条件的第一个索引。
自定义排序
为了对自定义类型或复杂结构进行排序,你需要实现 sort.Interface 接口,该接口包含三个方法:
Len() int:返回待排序的数据长度。Less(i, j int) bool:定义两个元素之间的比较规则。Swap(i, j int):交换两个元素的位置。
log
这篇博客介绍了日志如何打印
https://blog.csdn.net/xmcy001122/article/details/119916227
记录信息
-
简单日志:
-
致命错误:这些函数会在记录日志后调用
os.Exit(1)来终止程序。
-
恐慌:这些函数会记录日志并引发一个
panic。
配置日志记录器
你可以通过 log.SetFlags 和 log.SetPrefix 函数来自定义日志的输出格式:
// 设置日志前缀
log.SetPrefix("[APP] ")

// 设置日志格式标志
log.SetFlags(log.Ldate | log.Ltime | log.Lshortfile)

// 示例输出:2024/12/07 12:34:56 main.go:10: [APP] This is a log message
log.Println("This is a log message")
可用的标志包括:
log.Ldate:日期log.Ltime:时间log.Lmicroseconds:微秒精度的时间log.Llongfile:完整文件路径和行号log.Lshortfile:仅文件名和行号log.LUTC:使用 UTC 时间log.LstdFlags:等同于Ldate | Ltime
自定义输出
默认情况下,log 包会将日志输出到标准错误流 (stderr)。你可以通过 log.SetOutput 改变输出位置:
// 将日志输出到文件
file, err := os.OpenFile("app.log", os.O_APPEND|os.O_CREATE|os.O_WRONLY, 0644)
if err != nil {
    log.Fatalf("failed to open log file: %v", err)
}
defer file.Close()

log.SetOutput(file)

// 现在所有的日志都会被写入到 app.log 文件中
log.Println("Logging to file now")
创建自定义日志记录器
有时你可能需要在同一程序中有多个不同配置的日志记录器。log.New 函数可以帮助你创建新的日志记录器实例:
logger := log.New(
    os.Stdout,        // io.Writer
    "CUSTOM: ",       // prefix
    log.Ldate|log.Ltime, // flags
)

logger.Println("This is a custom logger message")
net
Go 语言的 net 包提供了对网络编程的支持,包括 TCP、UDP、Unix 域套接字等低级网络协议的操作,以及更高层次的抽象如 HTTP、FTP 等。
Go原理
Goroutine
Goroutine和线程的区别
栈的大小
每一个OS线程都有一个固定大小的内存块(一般会是2MB)来做栈,这个栈会用来存储当前正在被调用或挂起(指在调用其它函数时)的函数的内部变量。
但是和OS线程不太一样的是,一个goroutine的栈大小并不是固定的;栈的大小会根据需要动态地伸缩。而goroutine的栈的最大值有1GB
调度
OS线程会被操作系统内核调度。因为操作系统线程是被内核所调度,所以从一个线程向另一个“移动”需要完整的上下文切换,也就是说,保存一个用户线程的状态到内存,恢复另一个线程的到寄存器,然后更新调度器的数据结构。这几步操作很慢,因为其局部性很差需要几次内存访问,并且会增加运行的cpu周期。
Go的运行时包含了其自己的调度器,该调度器不是硬件定时器。当一个goroutine调用了time.Sleep,或者被channel调用或者mutex操作阻塞时,调度器会使其进入休眠并开始执行另一个goroutine,直到时机到了再去唤醒第一个goroutine。因为这种调度方式不需要进入内核的上下文,所以重新调度一个goroutine比调度一个线程代价要低得多
GOMAXPROCS
Go的调度器使用了一个叫做GOMAXPROCS的变量来决定会有多少个操作系统的线程同时执行Go的代码。其默认的值是运行机器上的CPU的核心数,所以在一个有8个核心的机器上时,调度器一次会在8个OS线程上去调度GO代码。在休眠中的或者在通信中被阻塞的goroutine是不需要一个对应的线程来做调度的。在I/O中或系统调用中或调用非Go语言函数时,是需要一个对应的操作系统线程的,但是GOMAXPROCS并不需要将这几种情况计算在内。
【例子】
for {
    go fmt.Print(0)
    fmt.Print(1)
}

$ GOMAXPROCS=1 go run hacker-cliché.go
111111111111111111110000000000000000000011111...

$ GOMAXPROCS=2 go run hacker-cliché.go
010101010101010101011001100101011010010100110...
在第一次执行时,最多同时只能有一个goroutine被执行。初始情况下只有main goroutine被执行,所以会打印很多1。过了一段时间后,GO调度器会将其置为休眠,并唤醒另一个goroutine,这时候就开始打印很多0了,在打印的时候,goroutine是被调度到操作系统线程上的。在第二次执行时,我们使用了两个操作系统线程,所以两个goroutine可以一起被执行,以同样的频率交替打印0和1。我们必须强调的是goroutine的调度是受很多因子影响的,而runtime也是在不断地发展演进的,所以这里的你实际得到的结果可能会因为版本的不同而与我们运行的结果有所不同。
Goroutine没有ID号
这部分我没读懂
https://golang-china.github.io/gopl-zh/ch9/ch9-08.html#:~:text=9.8.4.-,Goroutine%E6%B2%A1%E6%9C%89ID%E5%8F%B7,-%E5%9C%A8%E5%A4%A7%E5%A4%9A%E6%95%B0
Go面试题
Go语言习惯
本专题将指出Go语言编程一些好的习惯,这些习惯不影响程序运行
变量
命名驼峰式
如果没有对于性能的高要求,使用以下类型:
- int
- uint
- float64
- complex128
错误处理
if中处理错误然后直接返回,这样可以确保正常执行的语句不需要代码缩进。
错误示范
if f, err := os.Open(fname); err != nil {
    return err
} else {
    // f and err are visible here too
    f.ReadByte()
    f.Close()
}
正确示范
在Go中,错误处理有一套独特的编码风格。检查某个子函数是否失败后,我们通常将处理失败的逻辑代码放在处理成功的代码之前。如果某个错误会导致函数返回,那么成功时的逻辑代码不应放在else语句块中,而应直接放在函数体中。Go中大部分函数的代码结构几乎相同,首先是一系列的初始检查,防止错误发生,之后是函数的实际逻辑。
浮点数
一个float32类型的浮点数可以提供大约6个十进制数的精度,而float64则可以提供约15个十进制数的精度;通常应该优先使用float64类型,因为float32类型的累计计算误差很容易扩散,并且float32能精确表示的正整数并不是很大(译注:因为float32的有效bit位只有23个,其它的bit位用于指数和符号;当整数大于23bit能表达的范围时,float32的表示将出现误差):
函数
为了保证可读性
返回值需要赋予变量名,return也要给予变量名
defer
在循环体中的defer语句需要特别注意,因为只有在函数执行完毕后,这些被延迟的函数才会执行。下面的代码会导致系统的文件描述符耗尽,因为在所有文件都被处理之前,没有文件会被关闭。
for _, filename := range filenames {
    f, err := os.Open(filename)
    if err != nil {
        return err
    }
    defer f.Close() // NOTE: risky; could run out of file descriptors
    // ...process f…
}
一种解决方法是将循环体中的defer语句移至另外一个函数。在每次循环时,调用这个函数。
for _, filename := range filenames {
    if err := doFile(filename); err != nil {
        return err
    }
}
func doFile(filename string) error {
    f, err := os.Open(filename)
    if err != nil {
        return err
    }
    defer f.Close()
    // ...process f…
}
组合(代码复用)
嵌入结构体/接口,使得新的结构体能够复用方法和变量,从而实现代码复用,实现类似于继承的效果
当你在结构体中嵌入一个接口时,这个结构体自动获得了该接口的所有方法。
Go版本更新变更
之前强调过一个容易犯错的问题,在for循环中range声明的变量共享同一地址,迭代的方法是在这个地址上变更值。
对于for中的闭包来说,闭包读取的是变量地址,并且循环后才执行,这会导致每个闭包使用的是迭代最后的值
如下例子,打印出来的&value的值应为同一个值
使用闭包需要写成这样
    intArr := []int{1, 2, 4, 5}
    for _, value := range intArr {
    // 需要额外一个赋予闭包的变量
        v := value
        func() {
            fmt.Println(v)
        }()
    }
在Go1.22.2后,修复了这个bug,现在range声明的变量各自享有地址。因此以上提到的闭包的bug被修复
在以上例子中,打印出来的&value的值不是同一个值
现在使用闭包只需要写成这样
Go 使用技巧
vscode自动生成接口
ctrl/command + shift + P出现搜索栏
找到Go : Generate Interface Stubs并单击
按照 receiverName receiverType package.Interface格式输入,Enter确认