82 删除排序链表中的重复元素II
思路
题意分析
题目说的删除重复元素,并不是简单的「去重」,而是将「重复的元素都删掉」
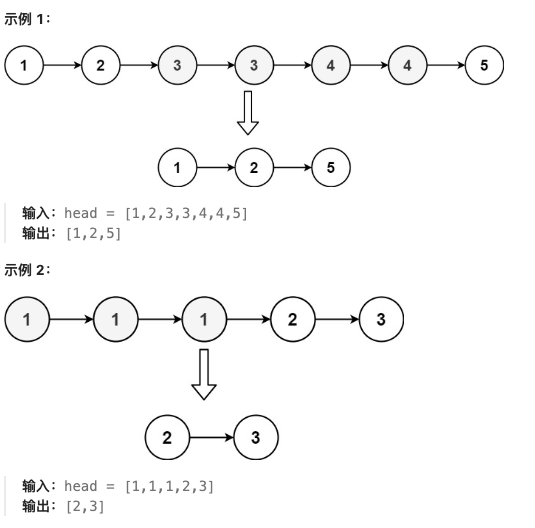
如上示例1,值为3的元素重复了两次,值为4的元素重复了两次,于是将所有值为3和4的元素都删除
而不是分别留下一个值为3的元素和值为4的元素
删除重复元素
如果不考虑内存释放
删除链表元素的方法我们应该已经知道,需要找到targetNode的前一个节点prevNode和后一个节点nextNode,如果不考虑内存释放,甚至不需要考虑targetNode
将这个思路延伸到本题,我们想要删除的不再是一个节点,而是「一连串」节点(由于题目给出了「升序」,因此删除的元素一定是连续的)
如果将这一连串的节点当作一个节点,应用我们之前的思路: - targetNode就是这一连串节点 - prevNode就是在过去遍历中不重复链表的最后一个节点 - nextNode就是未遍历链表的第一个节点
Solution
遍历链表,使用哈希表记录每个值对应的元素出现次数
遍历链表后,根据哈希表结果,将出现次数为1的元素按照值从小到大串联为新的已排序链表
唯一难点:STL用法
/**
* Definition for singly-linked list.
* struct ListNode {
*     int val;
*     ListNode *next;
*     ListNode() : val(0), next(nullptr) {}
*     ListNode(int x) : val(x), next(nullptr) {}
*     ListNode(int x, ListNode *next) : val(x), next(next) {}
* };
*/
struct CompareListNode {
    bool operator()(const ListNode* lhs, const ListNode* rhs) const {
        return lhs->val < rhs->val;
    }
};

class Solution {
public:
    ListNode* deleteDuplicates(ListNode* head) {
        map<ListNode*, int,CompareListNode> hashMap;
        ListNode* p = head;
        while(p != nullptr){
            hashMap[p] += 1;
            p = p->next;
        }
        ListNode* dummyNode = new ListNode(-1);
        ListNode* pp = dummyNode;
        for (auto pair : hashMap) {
            if(pair.second == 1){
                ListNode* ptr = pair.first;
                ptr->next = nullptr;
                pp->next = ptr;
                pp = pp->next;
            }
        }
        return dummyNode->next;
    }
};
由思路分析,我们自然想到快慢指针:
删除重复元素:
- 指针
fast指向遍历的元素,指针slow指向过去遍历中未重复链表的最后一个节点 - 当指针
fast遇到重复元素直接跳过,重复这一步骤,直到没有重复元素为止,最后fast指向新的未重复元素 slow指向此时的fast,完成删除
没有重复元素的时候正常遍历即可
/**
* Definition for singly-linked list.
* struct ListNode {
*     int val;
*     ListNode *next;
*     ListNode() : val(0), next(nullptr) {}
*     ListNode(int x) : val(x), next(nullptr) {}
*     ListNode(int x, ListNode *next) : val(x), next(next) {}
* };
*/
class Solution {
public:
    ListNode* deleteDuplicates(ListNode* head) {
        // 防止第一个元素就是要删除的重复元素,引入dummyNode
        // 题意条件为-100 <= Node.val <= 100,所以dummyNode值设为101
        ListNode* dummyNode = new ListNode(101);
        dummyNode->next = head;
        // 定义快慢指针,fast指向遍历的元素,slow指向已遍历的未重复链表的最后一个元素
        ListNode* fast = head;
        ListNode* slow = dummyNode;
        // 遍历原链表,遍历结束的条件是fast == nullptr
        while(fast != nullptr){
            // 判断是否有重复元素
            // 有重复元素
            if(fast->next != nullptr && fast->val == fast->next->val){
                // 一旦出现重复元素,重复元素可能不只一个,因此使用while
                while(fast->next != nullptr && fast->val == fast->next->val){
                    // 遇到重复元素直接跳过
                    fast = fast->next;
                }
                // 到达这一步时,fast指向重复元素的最后一个,我们需要nextNode
                fast = fast->next;
                // 此时fast为一连串重复元素的nextNode
                // nextNode可能为新的重复元素,因此交给下一次循环继续处理
                // 每次循环只处理相同值的一连串重复元素
            }
            // 没有重复元素
            else{
                slow->next = fast;
                fast = fast->next;
                slow = slow->next;
            }
        }
        // 给链表添上结尾
        slow->next = nullptr;
        return dummyNode->next;
    }
};
与快慢指针删除重复元素不同,我们也可以直接维护两个链表,一个收集未重复元素,一个收集重复元素
/**
* Definition for singly-linked list.
* struct ListNode {
*     int val;
*     ListNode *next;
*     ListNode() : val(0), next(nullptr) {}
*     ListNode(int x) : val(x), next(nullptr) {}
*     ListNode(int x, ListNode *next) : val(x), next(next) {}
* };
*/
class Solution {
public:
    ListNode* deleteDuplicates(ListNode* head) {
        // 创建两个链表,一个收集未重复元素,一个收集重复元素
        // 题意条件为-100 <= Node.val <= 100,所以dummyNode值设为101
        ListNode* dummyUniqNode = new ListNode(101);
        ListNode* dummyDupNode = new ListNode(101);
        ListNode* p1 = dummyUniqNode;
        ListNode* p2 = dummyDupNode;
        // 遍历原链表
        while(head != nullptr){
            // 重复元素判断有两种情况:
            // 情况1: head->next != nullptr && head->val == head->next->val说明当前元素和下一个元素重复
            // 情况2: 如果情况1失效,说明head到达一连串重复元素的最后一个元素,此时需要和已收集重复元素的最后一个元素比较
            // 因此情况2条件为head->val == p2->val
            if((head->next != nullptr && head->val == head->next->val) || head->val == p2->val){
                p2->next = head;
                p2 = p2->next;
            }
            // 未重复元素正常收集即可
            else{
                p1->next = head;
                p1 = p1->next;
            }
            head = head->next;
        }
        // 记得给链表末尾添上nullptr
        p1->next = nullptr;
        p2->next = nullptr;
        return dummyUniqNode->next;
    }
};
由思路分析和快慢指针解法分析可得出如下重复步骤:
- 从未遍历链表中找出第一个元素
fast和它的下一个元素fast->next - 比较两者大小是否相同
- 如果相同,则重复步骤1和步骤2。重复停止时,这时我们遍历的是重复元素的最后一个元素,找到其下一个元素,接着重复步骤1到3
- 如果不相同,更新不重复链表
slow->next = fast; slow = slow->next
递归参数: 未遍历链表的头节点head 递归返回值: 已排序且去掉重复元素的链表头 递归终止条件:第一个元素fast和它的下一个元素fast->next都为空
简单来说,递归做的事情只有一个:每次递归只去除一个值对应的多个重复元素
- 从未遍历的链表中找到同一个值重复的元素,去除重复的元素。
- 重复步骤1直到每种值重复的元素都被除掉,这时候返回已排序的链表头
/**
* Definition for singly-linked list.
* struct ListNode {
*     int val;
*     ListNode *next;
*     ListNode() : val(0), next(nullptr) {}
*     ListNode(int x) : val(x), next(nullptr) {}
*     ListNode(int x, ListNode *next) : val(x), next(next) {}
* };
*/
class Solution {
public:
    ListNode* deleteDuplicates(ListNode* head) {
        // 递归终止条件
        if(head == nullptr || head->next == nullptr)
            return head;
        // 没有重复元素
        if(head->val == head->next->val){
            head->next = deleteDuplicates(head->next);
            return head;
        }
        // 有重复元素
        while(head->next != nullptr && head->val == head->next->val){
            head = head->next;
        }
        // 去除多余的重复元素,此时head指向最后一个重复元素
        // head->next为新的未遍历链表的头节点
        return deleteDuplicates(head->next);
    }
};