链表
基本操作
遍历链表
一般我们拥有链表头head就拥有了整个链表,遍历链表时,我们通常保留链表头,创建一个新的指针p指向head,然后开始遍历。否则,我们将丢失head信息,也就丢失链表信息。
如果只是遍历一次链表之后不再使用该链表,则可以直接使用head作为遍历指针p
链表合并与断开
虚拟头节点
为什么需要虚拟头节点: 链表的增和删都需要使用目标节点curNode的前一个节点preNode和下一个节点nextNode,当目标节点恰好是头节点,其没有preNode,需要额外处理。而引入虚拟头节点后,让头节点也有了preNode,所有情况都可以统一处理,不需要额外讨论
同样地,创造新链表也需要保留链表头信息,因此创建过程也需要新指针p
ListNode* dummyNode = new ListNode();
ListNode* p = dummyNode;
if(condition)
    p->next = newNode;
p = p->next;
链表拼接
原链表的节点接到新链表上,而不是 new 新节点来组成新链表的话,需要注意两个操作:
-
初始化新链表
-
断开节点和原链表之间的链接(为什么需要断开节点与原链表之间的链接)。但凡遇到这种情况,就把原链表的节点断开,这样就不会出错了。
例如:
-
插入节点到新链表
举个例子:
相关题目:
- 链表合二为一:【leetcode 21】合并两个有序链表
- 原链表一分为二:【leetcode 86】分隔链表
- 链表合k为一:【leetcode 23】合并k个有序链表
双指针
利用双指针之间的距离,实现一次遍历获得链表的不同位置
通常开始时,p1与p2之间相距k,k为目的位置,
之后,p1和p2同时移动
结束时,p1指向链表末尾,p2为目的位置
求链表倒数第k个节点
求倒数第k个节点:因为p1指向链表末尾,所以p2和p1相距k
首先,我们先让一个指针 p1 指向链表的头节点 head,然后走 k 步
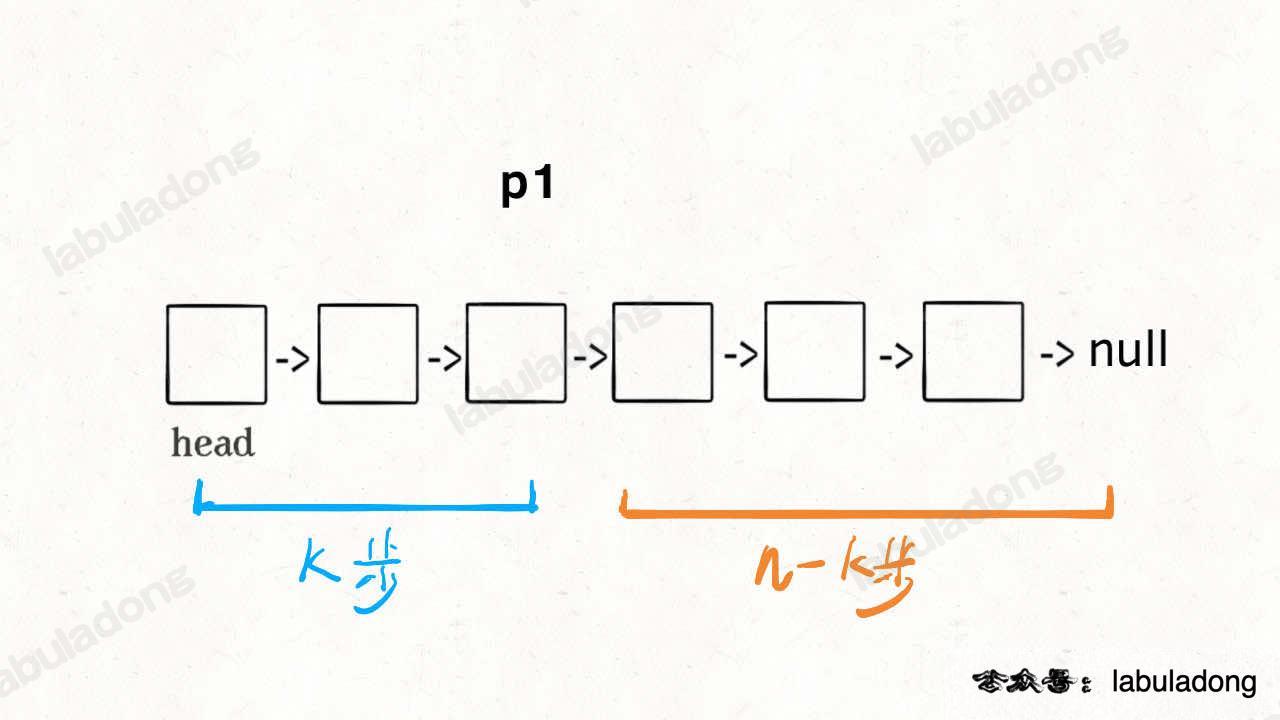
现在的 p1,只要再走 n - k 步,就能走到链表末尾的空指针了对吧?
趁这个时候,再用一个指针 p2 指向链表头节点 head:
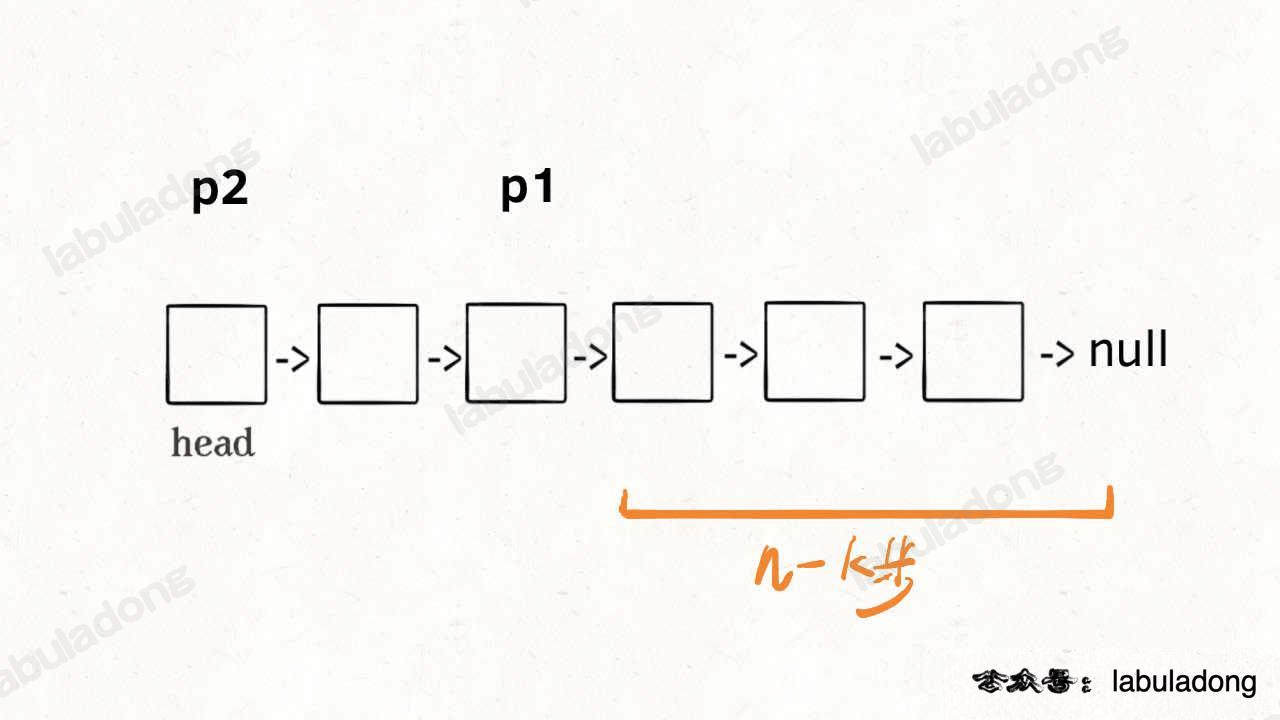
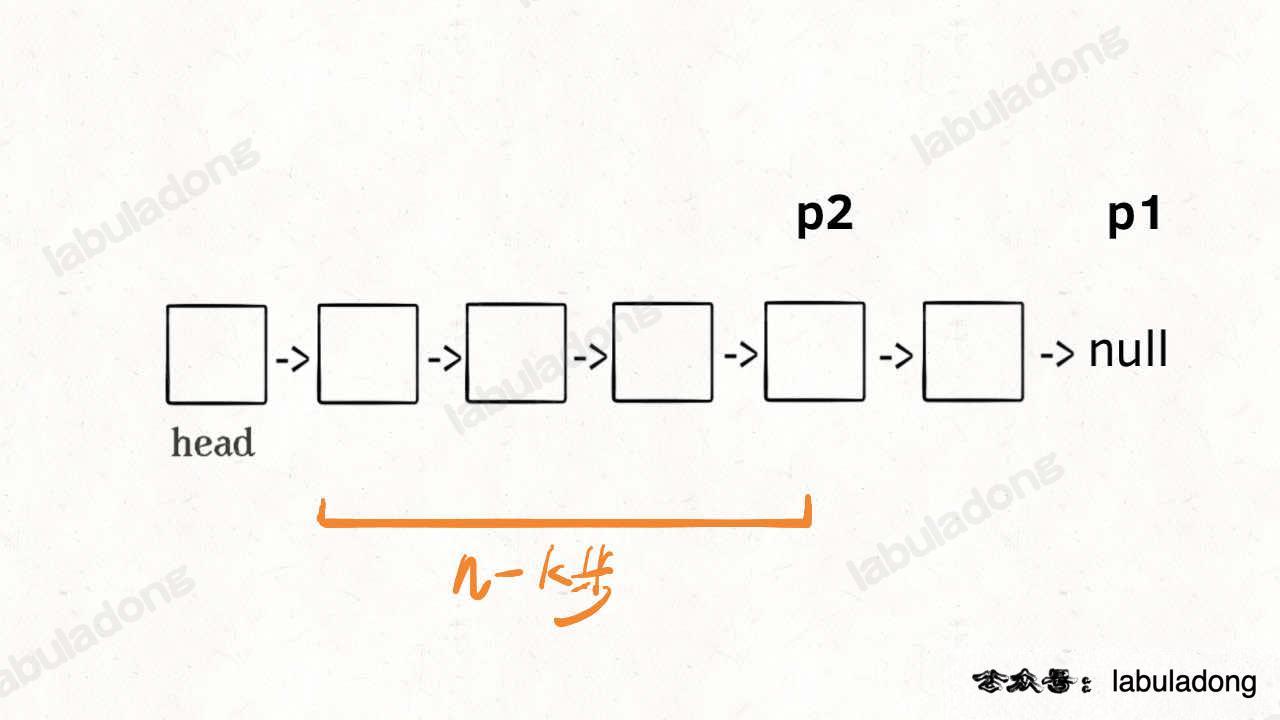
接下来就很显然了,让 p1 和 p2 同时向前走,p1 走到链表末尾的空指针时前进了 n - k 步,p2 也从 head 开始前进了 n - k 步,停留在第 n - k + 1 个节点上,即恰好停链表的倒数第 k 个节点上:
相关题目:
求链表的中点
求链表中点其实就是求倒数第n/2个节点,但是n我们并不知道,所以不能使用求链表倒数第k个节点
在这种情况下,我们可以使用「快慢指针」
我们让两个指针 slow 和 fast 分别指向链表头结点 head。
每当慢指针 slow 前进一步,快指针 fast 就前进两步,这样,当 fast 走到链表末尾的下一个元素(nullptr)时,slow 就指向了链表中点。
ListNode* fast = head, * slow = head;
// 注意不要遗漏fast->next != nullptr
// 这两个条件使得fast指向链表尾部的下一个元素(nullptr)
while(fast != nullptr && fast->next != nullptr){
    fast = fast->next->next;
    slow = slow->next;
}
return slow;
相关题目:
链表与环
相关题目:
- 判断链表是否包含环【leetcode 141】 环形链表
- 获得环的起点【leetcode 142】 环形链表II
两个链表是否相交
相关题目:
合并k个升序链表
合并两个有序链表
分解为两个基本操作:
- 创建新链表
- 比较两个链表元素,得出插入到新链表的元素,将其插入到新链表
相关题目:
合并k个升序链表
最直接的想法,每次合并2个升序链表,得到最后的链表。但这种方法时间复杂度很高,合并2个升序链表需要\(O(n_1 + n_2)\)时间复杂度,\(n_i\)为第i条有序链表元素个数,合并\(n - 1\)次(合并两条变成新的一条,新的链表与下一条链表比较),总共\(O(n^2)\)时间复杂度
我们可以维护一个最小堆,动态维护每个链表头,每次从最小堆取出k条链表的最小值插入到新链表,最小堆只存储k个元素,这一操作时间复杂度为\(O(logk)\),一共需要取N次,N为所有链表节点总数,时间复杂度为\(O(Nlogk)\)
相关题目:
链表应用
链表的分解
把重复的元素看成是一个节点,那么删除重复元素,就相当于删除一个元素
注意会不会删除头节点,如果有这种可能,那么引入dummyNode
「通用框架」是:
- slow指向删除节点的前一个节点,也就是未重复链表的最后一个节点;fast指向迭代的节点
- fast->val与fast->next->val比较,从而判断重复的元素。这种做法最后会让fast指向最后一个重复元素,根据题意是否要保留重复元素,选择是否要添加一步fast = fast->next
- 步骤2之后的fast为删除节点的下一个节点,slow->next = fast实现删除
- 注意slow维护的是新链表,因此需要slow->next断开链表末尾
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     ListNode *next;
 *     ListNode() : val(0), next(nullptr) {}
 *     ListNode(int x) : val(x), next(nullptr) {}
 *     ListNode(int x, ListNode *next) : val(x), next(next) {}
 * };
 */
class Solution {
public:
    ListNode* deleteDuplicates(ListNode* head) {
        ListNode* dummyNode = new ListNode(-1);
        dummyNode->next = head;
        ListNode* slow = dummyNode, *fast = head;
        while(fast != nullptr){
            if(fast->next != nullptr && fast->val == fast->next->val){
                while(fast->next != nullptr && fast->val == fast->next->val){
                    fast = fast->next;
                }
                // fast指向最后一个重复元素
                // 如果题目不需要保留重复元素,则添加以下代码,让fast再指向下一个元素
                // fast = fast->next
            }else{
                slow->next = fast;
                slow = slow->next;
                fast = fast->next;
            }
        }
        // 注意断开链表末尾
        slow->next = nullptr;
        return dummyNode->next;
    }
};
有时候也可以根据题意不使用通用框架,例如【leetcode 83】 删除排序链表中的重复元素保留一个重复元素,那么头节点不会被删除,所以可以不使用dummyNode
链表的合并
以下题目都可以转换为合并k条有序链表
丑数II
题目描述
给你一个整数 n ,请你找出并返回第 n 个 丑数 。 丑数 就是质因子只包含 2、3 和 5 的正整数。
可以将丑数分为2的倍数,3的倍数和5的倍数,每种对应一条有序链表
合并三条有序链表得到丑数链表
有序矩阵中第 K 小的元素
题目描述
给你一个 n x n 矩阵 matrix ,其中每行和每列元素均按升序排序,找到矩阵中第 k 小的元素。
请注意,它是 排序后 的第 k 小元素,而不是第 k 个 不同 的元素。

你必须找到一个内存复杂度优于 O(n2) 的解决方案。
查找和最小的 K 对数字
题目描述
给定两个以 非递减顺序排列 的整数数组 nums1 和 nums2 , 以及一个整数 k 。
定义一对值 (u,v),其中第一个元素来自 nums1,第二个元素来自 nums2 。

请找到和最小的 k 个数对 (u1,v1),  (u2,v2)  ...  (uk,vk) 。
可转换为: - 第一条链表: nums1[0]作为数对的第一个元素,剩余nums2的元素作为数对的第二个元素 - 第二条链表: nums1[1]作为数对的第一个元素,剩余nums2的元素作为数对的第二个元素 - 以此类推,总共nums1.size()条链表 - 接着合并这些链表即可
链表的运算
如果是逆序存储【leetcode 2】 两数相加,直接遍历链表就是从个位开始的,符合我们计算加法的习惯顺序。
如果是正序存储【leetcode 445】 两数相加 II,那倒要费点脑筋了,可能需要「翻转链表」或者使用「栈」来辅助。
相关题目: